Google은 질병과 유전체 연구, 날씨·재난 예측, 교육, 일자리 변화 대응에 AI를 적용한 사례를 한데 모아 공개했다. 여러 기술이 연구 단계를 넘어 검사와 예보에 쓰이고 있지만, 효과 수치는 대부분 Google이 제시한 결과이므로 분야별 검증 범위와 실제 이용 조건을 따로 확인해야 한다.
배경부터 이해하기
이 발표는 하나의 새 제품을 출시한 소식이 아니다. Google이 개발한 과학 연구 도구와 예측 모델, 교육 기능, 언어 기술이 현실에서 어떻게 쓰이는지 정리한 사례집에 가깝다. AI는 많은 자료에서 패턴을 찾아 질병 가능성이나 날씨 변화를 예측하지만, 결과 자체가 의료진이나 재난 당국의 최종 판단을 대신하지는 않는다.
기존에도 AlphaFold는 단백질의 입체 구조를 예측했고, Flood Hub는 홍수 정보를 제공했다. Google은 여기에 최근 유전체 자료, 새 기상 모델, 여러 위기 요인을 함께 다루는 예측 시스템과 세계 AI 이용 현황을 보여주는 AI & Economy ATLAS를 연결해 소개했다.
무엇이 바뀌었나
Google은 AlphaGenome Atlas에 인간 유전체에서 가능한 단일 글자 변화 약 90억 개를 지도화해 연구자가 공개적으로 이용할 수 있게 했다고 밝혔다. 유방암 연구에서는 여성 17만5천 명의 유방 촬영 자료를 대상으로, 기존 촬영에서 발견되지 않고 다음 정기검사 사이에 확인된 암 가운데 25%를 AI가 탐지했다고 설명했다. 이는 전체 유방암 탐지율이 25% 높아졌다는 뜻은 아니다.
WeatherNext 3는 하루 이상 앞선 강수 예측 정확도가 이전 기준보다 50% 높아졌다는 회사 측 결과와 함께 소개됐다. 구체적인 평가 방식은 발췌문에 없다. Planetary Prediction Engine은 콩고민주공화국 에볼라 유행에서 새로 나타날 집중 발생 지역의 83%를 미리 찾아냈다고 Google은 주장했다. Flood Hub의 중대한 홍수 위험 지역 예보 범위는 150여 개국 약 20억 명으로 확대됐고, Google 기술 전반은 세계 인구의 86%에 해당하는 70억 명이 쓰는 300개 이상의 언어를 지원한다고 밝혔다.
왜 중요한가
연구자는 유전적 변화 후보를 먼저 좁혀 실험 순서를 정할 수 있다. 의료기관은 AI가 표시한 의심 사례를 추가 검토 대상으로 삼을 수 있다. 재난 기관은 강수량이나 감염병 집중 지역을 더 일찍 예측하면 인력과 물자를 사전에 배치할 시간이 늘어난다.
제품 기획자에게는 AI의 가치가 단순한 문서 작성에만 있지 않다는 점도 중요하다. 신뢰할 수 있는 관측 자료, 현장 전문가의 판단, 위험 경보 절차와 연결할 때 실제 업무 변화로 이어진다는 사례를 보여준다.
실제로 어떤 의미인가
활용 예시: 한 지역 보건기관이 감염병 신고 자료와 식량·기후 자료를 각각 따로 확인하던 상황을 가정할 수 있다. 이전에는 담당자가 여러 보고서를 대조한 뒤 위험 지역을 골랐다면, 예측 시스템이 먼저 우선 점검 지역을 제시하고 담당자가 현장 신고와 검사 결과로 이를 검증한 뒤 인력과 물자를 배치하는 흐름으로 바뀔 수 있다. 이는 설명을 위한 가정이며, 해당 기관에서 실제 시험했다는 뜻은 아니다.
사용·공개 범위
AlphaGenome Atlas는 연구자에게 공개됐다고 명시됐다. WeatherNext 3는 Google 제품에서 이미 사용 중이며, Flood Hub는 150여 개국의 홍수 위험 지역을 대상으로 한다. Planetary Prediction Engine은 콩고민주공화국, 나이지리아, 미국의 사례가 제시됐지만 일반 기관이 직접 이용할 수 있는지와 이용료는 확인되지 않았다. AI & Economy ATLAS는 공개형 대화식 자료로 발표됐다. 의료·교육 기능은 지역과 협력기관에 따라 범위가 다르며, 통합된 일반 사용자용 서비스나 가격은 발표되지 않았다.
확인할 점
여러 제품과 연구 결과를 Google이 자체적으로 종합한 발표다. 강수 예측의 ‘50% 향상’, 위기 지역의 ‘83% 사전 식별’ 등은 회사가 제시한 평가이며 비교 대상, 오차 범위, 외부 검증 여부가 발췌문에 충분히 설명되지 않았다. 유방암 수치는 전체 환자나 모든 의료 환경에 그대로 적용할 수 없고, 연구 대상과 진료 절차를 함께 살펴야 한다. Google도 AI의 혜택은 자동으로 보장되지 않으며 정확성, 안전, 오용 위험을 관리해야 한다고 인정했다.
용어 풀이
유전체: 생물이 가진 유전정보 전체다. DNA의 특정 글자 변화가 질병이나 세포 활동에 어떤 영향을 주는지 연구할 때 사용한다. 예측 모델: 과거 자료와 현재 관측값에서 패턴을 찾아 앞으로 일어날 가능성을 계산하는 프로그램이다. 공개형 자료: 정해진 조건에 따라 외부 연구자나 일반인이 접근해 살펴보거나 연구에 활용할 수 있도록 공개한 자료다.
Microsoft, 2026년 가을 미국 정부용 Copilot에 문서 편집·회의 요약 기능 확대 예고
발행 2026-09-15
AI 뉴스 기본 이미지 · AI 생성 일러스트
Microsoft는 미국 정부기관용 Microsoft 365 Copilot을 GCC, GCC High, DoD 환경에서 확대하는 2026년 가을 계획을 발표하고 GCC용 Microsoft 365 G7을 소개했다. Word·Excel·PowerPoint 편집과 Teams 회의 요약 등이 추가될 예정이어서 정부기관도 보안 등급에 맞춰 AI 업무 절차를 준비할 수 있지만, 모든 기능이 지금 동시에 출시된 것은 아니다.
배경부터 이해하기
Microsoft 365 Copilot은 Word, Excel, PowerPoint, Outlook, Teams 같은 업무 프로그램에서 초안 작성, 자료 정리, 요약을 돕는 AI 기능이다. 여기서 에이전트는 사용자의 지시에 따라 여러 단계를 이어서 처리하도록 만든 AI 도구를 뜻한다. 예를 들어 자료를 찾고 분석한 뒤 결과를 문서로 정리하는 순서를 맡을 수 있다.
미국 정부용 서비스는 보안과 규정 준수 수준에 따라 GCC, GCC High, DoD로 나뉜다. 따라서 일반 기업용 Microsoft 365에 나온 기능이 정부 환경에 같은 시점에 들어온다고 볼 수 없다. Microsoft의 이전 발표에 따르면 정부 클라우드에는 조사·분석 도구와 에이전트 제작 기능이 단계적으로 제공됐고, GCC High용 Microsoft 365 Copilot은 2025년 12월부터 이용 가능해졌다.
무엇이 바뀌었나
Microsoft는 GCC용 Microsoft 365 G7을 발표하고, 2026년 가을에 GCC·GCC High·DoD 전반으로 Copilot 기능을 더 확대할 계획이라고 밝혔다. 문서 초안, 요약, 조사와 여러 단계의 추론에는 OpenAI GPT-5.6을 적용할 예정이다. 사용자의 업무 맥락을 반영하는 메모리와 개인화 기능도 계획에 포함됐다.
Word, Excel, PowerPoint에서는 문서 안에서 바로 내용을 고치는 ‘Copilot으로 편집’ 기능이 예고됐다. Outlook에서는 별도 Copilot 추가 라이선스가 없는 이용자에게도 Copilot Chat 범위를 넓힐 계획이다. Copilot Notebooks의 새 화면과 OneNote 연동, Forms 지원도 포함된다. GCC High에는 채팅·채널·통화·회의를 아우르는 통합 Teams Copilot이, DoD에는 지능형 회의 요약이 각각 예정됐다.
왜 중요한가
정부기관은 민감한 자료를 다루기 때문에 일반 서비스와 다른 보안 환경에서 기능을 검토해야 한다. 이번 로드맵은 어떤 문서 작업과 회의 절차가 자동화 대상이 될지 미리 보여준다. 기관 담당자는 기능이 들어오기 전에 문서 접근 권한, 기록 보존, 사람이 확인해야 할 단계와 AI 사용 지침을 정할 수 있다.
특히 문서 안에서 직접 수정하거나 회의 결과를 자동 정리하면 여러 프로그램 사이에서 내용을 복사하는 일이 줄어들 수 있다. 다만 효율 향상 여부는 각 기관의 클라우드 등급, 라이선스와 승인 절차에 따라 달라진다.
실제로 어떤 의미인가
가정한 예시: GCC High를 쓰는 정부기관 직원이 Teams 회의 뒤 보고서를 만드는 상황을 생각할 수 있다. 이전에는 채팅과 회의 메모를 읽고 Word에 핵심 결정과 후속 업무를 옮겼다면, 향후 통합 Copilot이 회의 내용을 정리하고 Word에서 초안을 바로 수정하도록 도울 수 있다. 직원은 원문과 요약을 대조하고 민감정보와 결정 사항을 확인한 뒤 문서를 승인한다. 이는 발표된 기능을 바탕으로 한 활용 예시이며 실제 기관의 검증 사례는 아니다.
사용·공개 범위
이번 발표는 전 세계 일반 고객 대상의 즉시 출시가 아니라 미국 정부 클라우드용 로드맵이다. Microsoft 365 G7 for GCC는 소개됐고, 더 넓은 Copilot 기능 확대는 2026년 가을로 계획됐다. 개별 기능은 GCC, GCC High, DoD 가운데 적용 대상이 서로 다르며 공개 로드맵에 따라 순차 제공된다. 정확한 출시일, 기관별 활성화 시점, G7과 추가 Copilot 라이선스의 가격은 제공된 자료에서 확인되지 않았다.
확인할 점
다수 기능은 이미 쓸 수 있는 정식 출시가 아니라 향후 계획이다. 일정과 기능은 변경될 수 있고, 각 정부 클라우드의 보안 심사와 관리 설정에 따라 실제 제공 시점이 달라질 수 있다. Outlook의 Copilot Chat 확대가 예고됐다고 해서 모든 고급 Copilot 기능을 추가 비용 없이 쓸 수 있다는 뜻은 아니다. GPT-5.6의 품질이나 업무시간 절감 정도를 보여주는 구체적인 평가 결과도 제시되지 않았다.
용어 풀이
Copilot: Microsoft 업무 프로그램 안에서 문서 작성, 검색, 요약과 자료 정리를 돕는 AI 기능의 이름이다. 에이전트: 사용자가 정한 목표에 맞춰 검색, 분석, 작성 같은 여러 작업 단계를 이어서 수행하도록 만든 AI 도구다. GCC·GCC High·DoD: 미국 정부기관의 보안 및 규정 준수 요구에 맞춘 서로 다른 Microsoft 클라우드 환경이다.
Google은 자사 기술과 제품이 300개가 넘는 언어를 지원하며, 음성을 글로 바꾼 뒤 처리하는 방식에서 벗어나 말투·감정·언어 혼용까지 직접 다루는 AI를 확대한다고 밝혔다. 이는 번역과 음성 입력을 더 자연스럽게 만들 수 있지만, 300개 언어 모두에서 같은 기능과 정확도를 제공한다는 의미는 아니다.
배경부터 이해하기
전통적인 음성 번역은 사람이 한 말을 먼저 글자로 옮기고, 그 글을 번역한 뒤 다시 음성으로 읽는 여러 단계를 거쳤다. 이 과정에서는 말의 속도, 감정, 머뭇거림과 억양 같은 정보가 줄어들 수 있다. 한 문장에서 두 언어를 섞어 쓰거나 지역별 표현을 사용할 때도 처리하기 어렵다.
Google Translate는 2006년 시작됐으며 현재 250개가 넘는 언어를 다룬다고 Google은 설명했다. 그러나 인터넷에는 일부 주요 언어 자료가 지나치게 많고, 소수 언어와 방언 자료는 부족하다. Google은 현지 대학과 공동체에서 음성 자료를 모으고, 인터넷이 불안정한 환경에서도 작동하는 가벼운 번역 모델을 개발하는 방식으로 이 격차를 줄이려 한다.
무엇이 바뀌었나
Google은 자사 기술과 제품이 70억 명 이상이 사용하는 300개 넘는 언어를 지원한다고 밝혔다. 70억 명은 세계 인구의 86%에 해당한다는 설명이다. 이는 모든 언어가 모든 Google 제품에서 지원된다는 뜻이 아니라, 회사 기술과 제품 전체를 합친 범위다. Gemini 3.5 Live Translate는 70개 언어와 2천 개가 넘는 언어 조합에서 실시간 음성 번역을 제공하며, 언어를 섞어 쓰는 표현과 감정 신호도 다룬다고 소개됐다.
Google은 1천 개 주요 언어 지원을 장기 목표로 제시했다. Universal Speech Model은 1천200만 시간의 음성으로 학습해 자료가 적은 언어에도 다른 언어에서 배운 패턴을 적용한다. WAXAL 공개 자료는 아프리카 27개 언어를, Project Vaani는 15만5천 명 이상에게서 수집한 109개 언어와 3만 시간 이상의 음성을 포함한다. TranslateGemma는 55개 언어를 다루며 기기 안에서 실행할 수 있어 인터넷 연결 없이 번역할 수 있다고 Google은 밝혔다.
왜 중요한가
여러 언어를 쓰는 이용자는 말한 내용을 먼저 표준적인 문장으로 고칠 필요 없이 번역이나 음성 입력을 이용할 가능성이 커진다. 기기 안에서 번역하면 연결이 불안정한 지역에서도 쓸 수 있고, 음성을 외부 서버로 보내지 않는 방식의 제품을 설계할 여지도 생긴다. 다만 기기 성능은 필요하다.
개발자와 현지화 담당자는 단어 대응만 확인하는 데서 그치지 않고 억양, 감정, 방언, 두 언어를 섞는 대화까지 시험해야 한다. 현지 공동체가 수집한 자료를 활용하면 주요 언어 중심의 서비스가 놓치던 발음과 표현을 반영할 수 있다.
실제로 어떤 의미인가
활용 예시: 영어와 힌디어를 섞어 상담하는 이용자가 휴대전화 음성 기능으로 문의하는 상황을 가정할 수 있다. 이전 방식에서는 음성을 먼저 한 언어의 글로 옮기는 과정에서 섞인 표현이나 감정이 빠질 수 있었다. 직접 음성을 처리하는 방식에서는 언어 전환과 말투를 반영한 번역 초안을 만들고, 상담원이 원음과 번역을 비교해 뜻을 확인하는 흐름이 가능하다. 이는 기능을 설명하기 위한 가정이며 실제 상담 현장에서 시험됐다는 뜻은 아니다.
사용·공개 범위
Gemini 3.5 Live Translate는 70개 언어와 2천 개 이상의 언어 조합을 지원한다고 발표됐다. TranslateGemma는 55개 언어용 가벼운 공개 번역 모델로 소개됐으며 기기에서 실행할 수 있다. 수화 음성을 글로 바꾸는 기능은 50개가 넘는 수화로 학습됐지만, 제품 적용은 Pixel 11의 Gboard와 Live Transcribe에서 미국수화에서 영어로 변환하는 기능부터 시작한다고 명시됐다. WAXAL 등 일부 데이터는 공개 자료다. 국가별 출시 범위, 지원 기기 전체 목록과 가격은 확인되지 않았다.
확인할 점
지원 언어 수는 제품마다 다르다. 회사 기술 전체의 300개 이상, Translate의 250개 이상, 실시간 음성 번역의 70개, TranslateGemma의 55개를 같은 범위로 해석하면 안 된다. 86%는 지원 언어를 사용하는 인구의 비중이지, 이용자 수나 번역 정확도가 86%라는 뜻이 아니다. 억양·감정·속어를 이해한다는 설명과 ‘가장 정밀하다’는 평가는 Google의 주장으로, 언어별 오류율이나 외부 비교 결과는 제공된 자료에 없다.
용어 풀이
음성 인식: 사람이 말한 소리를 컴퓨터가 알아듣고 글자나 명령으로 바꾸는 기술이다. 기기 내 실행: 자료를 인터넷 서버로 보내지 않고 휴대전화나 컴퓨터 자체에서 프로그램을 작동시키는 방식이다. 다중 형태 자료: 글, 소리, 이미지처럼 서로 다른 종류의 정보를 함께 담은 자료다.
Google은 국가와 직업에 따른 AI 사용 데이터를 직접 탐색할 수 있도록 ‘AI & Economy ATLAS’에 공개형 대화식 화면을 추가했다. 과학자 설문에서는 AI가 연구 시간을 줄이는 한편, 검증과 실험 단계의 적체를 키울 가능성도 나타났다.
배경부터 이해하기
ATLAS는 사람들이 사무실, 연구실, 창작 현장과 가정에서 AI를 어떻게 쓰는지 추적하는 Google의 장기 연구 프로젝트다. 새 화면이 나오기 전에도 관련 데이터와 연구는 있었지만, 이번에는 수백만 개의 세계 데이터를 직업·국가·용도별로 살펴보기 쉬운 형태로 제공한다.
함께 공개된 과학 분야 연구는 Google과 Google DeepMind가 MIT FutureTech와 협력해 진행했다. 전문 분야용 AI 모델 2,600개를 분석하고 미국과 영국 과학자 600명 이상을 설문했다.
무엇이 바뀌었나
이용자는 전기기사부터 구매 관리자까지 직업별 AI 사용률을 비교하고, 가정에서 AI를 쓰는 방식과 국가별 도입률을 탐색할 수 있다. OECD 국가에서는 컴퓨터·수학 직군과 경영·금융 직군의 사용 비중이 높았고, 비OECD 국가에서는 사무·행정 지원과 예술·미디어, 교육·도서관 직군이 상위권이었다.
Google에 따르면 인도에서는 예술·디자인·미디어 직군이 업무 관련 AI 사용의 19%를 차지했다. 이는 해당 직군이 전체 업무용 AI 사용에서 차지하는 비중이 세계 평균의 1.6배라는 뜻이다. 미국에서는 컴퓨터·수학 직군의 비중이 30%로, 나머지 세계에서 관측된 비중의 두 배였다. 과학자 설문에서는 거의 절반이 매일 어떤 형태로든 AI를 쓴다고 답했고, 주당 절약 시간은 평균 7시간에 조금 못 미쳤다.
왜 중요한가
기업이나 연구기관은 단순한 전체 도입률 대신 어떤 직군과 업무에서 AI가 많이 쓰이는지 비교할 수 있다. 이에 따라 교육이나 지원이 필요한 부서를 더 구체적으로 찾을 수 있다. 다만 과학 연구에서는 문서 작성과 분석이 빨라져도 AI 결과 확인, 실제 실험, 임상 검증이 같은 속도로 진행되지는 않았다. 앞 단계의 생산성 향상이 최종 발견 증가로 이어지려면 검증 절차와 인력 배치도 함께 바꿔야 한다는 의미다.
실제로 어떤 의미인가
활용 예시: 한 제조업체가 ATLAS에서 국가별 수리·진단 용도의 AI 사용 비중을 비교한다고 가정할 수 있다. 자료에서는 브라질과 독일의 실시간 장비 진단·문제 해결 등 수작업 관련 용도가 업무용 AI 사용의 7%였고, 일본은 4%였다. 업체는 이 차이를 참고해 정비 인력 교육 후보 지역을 정할 수 있지만, ATLAS 수치만으로 실제 생산성이나 투자 효과를 확정해서는 안 된다.
사용·공개 범위
새 ATLAS 탐색 화면은 공개 접근 방식으로 출시됐다. 제공 국가, 로그인 필요 여부, 별도 이용료 유무는 출처에서 구체적으로 확인되지 않았다. 과학자 활용 결과는 연구 자료로 공개된 것이며, 별도의 상용 제품 출시는 아니다.
확인할 점
직업별 비율은 해당 직군이 ‘업무 관련 AI 사용 전체’에서 차지하는 몫이지, 그 직군 종사자 가운데 AI를 쓰는 사람의 비율과는 다르다. 과학자 연구는 미국과 영국의 600명 이상을 대상으로 했으며, 전 세계 과학자를 대표하는지는 확인되지 않았다. 절약 시간은 과학자들이 보고한 수치다. Google과 협력 기관의 연구 결과이므로, 결과 검증에 드는 시간과 아직 시험하지 못한 가설의 증가도 함께 봐야 한다.
용어 풀이
대화식 시각화: 사용자가 국가, 직업, 용도 같은 조건을 선택해 그래프와 수치를 직접 바꿔 보는 화면이다. 전문 분야용 AI 모델: 의료나 생명과학처럼 특정 분야의 예측·생성·모의실험에 맞춰 만든 AI다. 도입률: 특정 국가나 직업에서 AI가 실제 업무에 사용되는 정도를 나타내는 지표다.
Apple, macOS 27에서 기기 내 AI를 터미널·파이썬으로 쓰는 기능 준비—예비 문서와 사용자 보고
발행 2026-09-16
AI 뉴스 기본 이미지 · AI 생성 일러스트
한 Reddit 이용자는 macOS 27에서 Apple의 AI 모델을 ‘fm chat’ 명령으로 터미널에서 실행할 수 있다고 보고했다. Apple 개발자 자료도 터미널 도구와 Python 지원 방향을 설명하지만 문서가 예비 상태이므로, 현재 일반 사용자를 위한 정식 출시로 단정할 수는 없다.
배경부터 이해하기
Apple Foundation Models는 Apple Intelligence에 쓰이는 AI 모델을 개발자가 앱이나 도구에 연결하도록 마련된 체계다. 기기 안에서 처리하는 소형 모델과 필요에 따라 Private Cloud Compute를 이용하는 모델 접근 방식이 포함된다.
Apple 자료에서는 Swift로 만든 앱이 네이티브 API를 통해 이 모델을 사용할 수 있다고 설명한다. API는 프로그램이 다른 기능이나 서비스에 요청을 보내고 결과를 받도록 정한 연결 규칙이다. 이번 보고의 초점은 같은 모델 계열을 앱 코드뿐 아니라 터미널과 Python에서도 다룰 수 있다는 점이다.
무엇이 바뀌었나
r/LocalLLaMA 게시물 작성자는 macOS 27에서 ‘fm chat’ 명령을 실행해 Apple Foundation Models와 대화할 수 있었다고 적었다. 이는 커뮤니티의 사용 관찰이며 Apple의 정식 출시 공지 자체는 아니다.
제공된 Apple 개발자 자료 요약에 따르면 ‘fm’ 명령줄 도구는 Foundation Models를 터미널에서 쓰는 새로운 방법이다. macOS 27은 모델을 터미널에 연결하고, Python 개발자용 도구도 같은 기기 내 모델에 접근하도록 할 예정이다. 문서에 언급된 용도에는 요약, 문장에서 이름이나 장소 같은 항목 추출, 텍스트·이미지 이해가 포함된다.
왜 중요한가
기능이 예고된 형태로 제공되면 개발자는 완성된 Mac 앱을 먼저 만들지 않고도 터미널에서 지시문과 결과를 빠르게 확인할 수 있다. Python으로 데이터 처리 도구를 만드는 사람도 같은 기기 내 모델을 작업 흐름에 연결할 수 있다. 기기 내 처리는 요청을 Mac에서 실행한다는 뜻이지만, 더 복잡한 기능은 Private Cloud Compute나 다른 서버 모델을 이용할 수 있으므로 모든 작업이 항상 로컬에서 끝난다고 해석해서는 안 된다.
실제로 어떤 의미인가
가정한 예시: 문서 정리 도구를 만드는 개발자가 긴 회의록에서 담당자와 일정을 추출하려 한다. 먼저 터미널의 ‘fm chat’으로 지시문이 원하는 형식의 결과를 내는지 확인한 뒤, 같은 유형의 작업을 Python 처리 과정이나 Swift 앱에 연결할 수 있다. 이는 가능한 개발 흐름을 설명한 예시이며, 출처에서 실제로 시험한 사례는 아니다.
사용·공개 범위
macOS 27 환경에서 기능이 관찰됐다는 커뮤니티 보고와 예비 개발자 문서가 제시됐다. 정식 출시일, 지원 Mac 기종, 지역, 일반 사용자의 이용 조건, 가격은 출처에서 확인되지 않았다. 따라서 현재 상태는 확정된 일반 배포 제품보다 미리 공개된 개발 기능 또는 시험 단계 보고로 보는 것이 안전하다.
확인할 점
핵심 사용 후기는 Reddit 게시물에 근거하며 독립적인 재현 결과가 제공되지 않았다. Apple 문서도 예비 자료로 표시됐다고 전해져 명령어와 지원 범위가 바뀔 수 있다. ‘기기 내 AI’라는 표현은 모든 요청이 로컬에서 처리된다는 보장이 아니다. 일부 기능은 Private Cloud Compute나 다른 서버 모델을 사용할 수 있다.
용어 풀이
명령줄 도구: 아이콘을 누르는 대신 터미널에 ‘fm chat’ 같은 명령을 입력해 사용하는 프로그램이다. 기기 내 모델: 주요 계산을 외부 서버가 아니라 사용자의 Mac 같은 기기에서 수행하는 AI 모델이다. Private Cloud Compute: 기기만으로 처리하기 어려운 요청을 Apple의 원격 컴퓨팅 환경에서 처리하는 방식이다.
UkisAI, Qwen3.8-27B의 긴 사고 과정을 줄인 모델 공개—커뮤니티 코딩 시험서 출력 토큰 42% 감소
발행 2026-09-16
Reddit r/LocalLLaMA · 출처 이미지
UkisAI는 답을 만들기 전 지나치게 긴 사고 과정을 생성하는 경향을 줄이도록 Qwen3.8-27B를 조정한 Swift-Qwen3.8-27B를 공개했다. 커뮤니티 코딩 시험에서는 비슷한 정답 수준을 보이면서 출력량과 처리 시간이 줄었지만, 결과는 게시자 자체 환경에서 측정돼 추가 검증이 필요하다.
배경부터 이해하기
Swift-Qwen3.8-27B는 완전히 새로운 기본 모델이 아니라 Qwen3.8-27B를 다시 조정한 파생 모델이다. ‘27B’는 모델의 규모를 나타내는 이름 일부다. 출처는 이 숫자가 실제 실행에 필요한 메모리나 지원 하드웨어를 정확히 뜻한다고 설명하지 않는다.
AI는 문장을 작은 처리 단위인 토큰으로 나눠 입력받고 출력한다. 사고 토큰은 최종 답을 내기 전에 모델이 풀이 과정을 구성하며 생성하는 토큰이다. 이 과정이 길어지면 답변 대기 시간과 이전 내용을 보관하는 메모리 부담이 커질 수 있다.
무엇이 바뀌었나
UkisAI의 모델 설명서는 과도한 사고를 유발하는 표시용 토큰을 찾아 그 사용을 줄이도록 모델을 미세 조정했다고 설명한다. 회사 측 측정에서는 사고 토큰이 58.3% 감소했다. 이는 기존보다 58.3%만큼 줄었다는 뜻이며, 기존의 58.3% 수준으로 줄었다는 의미가 아니다. 성능 손실은 1% 미만이고 여러 작업에서 속도는 1.95배였다는 주장도 담겼다.
Reddit 작성자의 Aider 코딩 시험에서는 첫 시도 통과율이 비교 모델 27.1%에서 Swift 모델 30.8%로, 두 번째 시도까지의 통과율은 77.6%에서 75.7%로 바뀌었다. Aider 시험은 코드 수정 과제를 얼마나 통과하는지 보는 평가다. 출력 토큰은 12,547개에서 7,301개로 약 42% 감소했고, 사례당 시간은 1,481초에서 750초로 약 49% 줄었다. 문제 하나를 푸는 데 쓰인 전체 토큰은 19,300개에서 12,100개로 약 37% 감소했다.
왜 중요한가
비슷한 코딩 과제 성공률을 유지하면서 생성량을 줄일 수 있다면 사용자는 답을 더 빨리 받고, 운영자는 한 요청을 처리하는 데 필요한 계산과 메모리 부담을 낮출 수 있다. 특히 긴 풀이를 계속 저장해야 하는 환경에서는 전체 토큰 감소가 동시에 처리할 수 있는 작업 수에 영향을 줄 수 있다. 다만 두 번째 시도까지의 통과율과 올바른 코드 변경 형식 비율은 비교 모델보다 조금 낮아, 효율 향상이 모든 품질 지표의 개선을 뜻하지는 않는다.
실제로 어떤 의미인가
가정한 예시: 개발자가 여러 파일을 고치는 코딩 요청을 두 모델에 맡긴다고 하자. 커뮤니티 시험과 비슷한 결과가 재현된다면 Swift 모델은 비교 모델이 12,547개의 출력 토큰을 만들던 작업을 7,301개 정도로 마칠 수 있다. 개발자는 대기 시간을 줄일 가능성이 있지만, 생성된 코드가 실제 시험을 통과하는지 별도로 확인해야 한다.
사용·공개 범위
모델 설명서에는 Transformers, vLLM, SGLang, Docker와 GGUF 또는 양자화 변형을 통한 사용 경로가 제시됐다. 이는 로컬 컴퓨터와 서버 배포를 염두에 둔 공개 모델로 설명돼 있다. 구체적인 라이선스 조건, 최소 하드웨어, 호스팅 서비스, 가격은 제공된 출처에서 확인되지 않았다.
확인할 점
58.3%의 사고 토큰 감소, 1% 미만의 성능 손실, 1.95배 속도 향상은 UkisAI 모델 설명서의 자체 주장이다. Reddit 수치는 게시자가 자신의 평가 환경에서 측정한 결과로, 공식 평가 기관의 감사나 폭넓은 제3자 시험이 아니다. 커뮤니티 시험의 출력 토큰 감소율은 약 42%, 전체 토큰 감소율은 약 37%로 회사가 제시한 58.3%와 측정 대상과 수치가 다르다. 첫 시도 통과율은 높았지만 두 번째 시도까지의 통과율은 77.6%에서 75.7%로 낮아졌다.
용어 풀이
토큰: AI가 글을 읽고 만들 때 사용하는 짧은 문자나 단어 조각이다. 미세 조정: 기존 AI 모델이 특정 방식으로 답하도록 추가 자료로 다시 학습시키는 과정이다. 벤치마크: 정해진 과제를 주고 정답률, 처리 시간, 출력량 등을 비교하는 시험이다.
레딧 사용자가 Qwen3.8-27B를 100만 토큰까지 확장한 4개 GPU 실행 설정을 공개
발행 2026-09-16
Reddit r/LocalLLaMA · 출처 이미지
레딧의 한 사용자가 Qwen3.8-27B를 로컬 서버에서 최대 100만 토큰 길이로 실행하기 위한 vLLM 명령과 GPU 구성을 공유했다. 공식 성능 검증은 아니지만, 긴 자료 처리와 도구 호출을 한 환경에 묶으려는 개발자가 참고할 수 있는 구체적인 실험 기록이다.
배경부터 이해하기
Qwen3.8-27B는 약 270억 개의 매개변수를 가진 이미지·텍스트 처리 모델이다. 토큰은 모델이 글을 읽고 만드는 기본 단위다. 공식 모델 설명에 따르면 기본 문맥 길이는 26만2,144토큰이며, YaRN이라는 확장 기법으로 최대 100만 토큰까지 늘릴 수 있다.
로컬 추론은 외부 서비스 대신 사용자가 보유한 컴퓨터에서 모델이 답을 계산하도록 하는 방식이다. 작성자는 컨테이너로 포장된 환경이 아니라 서버 운영체제에서 vLLM을 직접 실행했으며, 이 기술 구성에 익숙하지 않은 상태에서 안정성을 시험하고 있다고 밝혔다.
무엇이 바뀌었나
작성자는 24GB 메모리를 갖춘 RTX Pro 4000 GPU 4개와 EPYC Milan 서버 보드를 사용했다. 모델 계산을 네 GPU에 나누고, 이전 대화 내용을 저장하는 KV 캐시는 FP8 형식으로 줄였다. 최대 모델 길이는 100만 토큰으로 지정했으며, 기본 길이 26만2,144토큰을 기준으로 YaRN 확장을 적용했다.
설정에는 모델의 사고 형식과 도구 호출 출력을 해석하는 기능도 포함됐다. 또한 다음 결과를 미리 추정해 생성을 빠르게 하는 추측 디코딩을 한 번에 3토큰씩 사용했다. 작성자는 현재 사용할 수 있는 상태라고 설명했으며, 브라우저에서 작동하는 DOS 게임 재현 과제 등을 통해 어느 지점에서 실패하는지 시험 중이다.
왜 중요한가
매우 긴 문서를 로컬에서 처리하려면 모델 지원 여부만으로는 부족하다. 여러 GPU에 계산을 나누는 방법, 메모리 절약 형식, 문맥 확장 설정이 함께 맞아야 한다. 이번 글은 이런 항목을 하나의 실행 명령에 모았다는 점에서 재현용 출발점이 된다. 도구 호출까지 포함돼 있어, 모델이 답변만 쓰는 것이 아니라 외부 프로그램에 작업을 요청하는 자동화 환경을 구성할 때도 참고할 수 있다.
실제로 어떤 의미인가
활용 예시: 개발자가 대형 코드 저장소와 긴 설계 문서를 로컬 모델에 함께 읽히려 한다고 가정할 수 있다. 일반적인 짧은 문맥 설정에서는 자료를 잘게 나누고 매번 관련 부분을 다시 찾아 넣어야 한다. 이 구성을 적용하면 더 많은 자료를 한 요청에 담고, 모델이 분석 결과에 따라 검색 도구나 테스트 프로그램을 호출하도록 설계할 수 있다. 다만 실제로 100만 토큰 전체에서 정확도가 유지된다는 뜻은 아니다.
사용·공개 범위
개인 사용자가 공개한 로컬 실행 실험이며 정식 제품 출시나 호스팅 서비스 발표가 아니다. Qwen3.8-27B는 Apache 2.0 라이선스로 제공되고 vLLM 등에서 실행할 수 있다. Qwen의 공식 호스팅은 출처에서 출시 예정으로만 표시됐으며, 시점과 가격은 확인되지 않았다. 같은 구성을 쓰려면 작성자가 사용한 수준의 서버와 GPU가 별도로 필요하다.
확인할 점
작성자 본인도 실패 지점을 찾는 시험 단계라고 밝혔다. 100만 토큰 설정이 작동한다는 관찰은 정확도, 처리 속도, 메모리 사용량을 체계적으로 측정한 공식 벤치마크가 아니다. 특정 GPU 4개와 사용자 지정 설정에서 나온 결과이므로 다른 하드웨어에서 그대로 재현된다고 단정할 수 없다. 원문 자동 수집에도 제한이 있어 세부 절차는 연결된 게시물과 모델 문서를 직접 확인해야 한다.
용어 풀이
문맥 길이: 모델이 한 번의 작업에서 참고할 수 있는 입력과 대화 기록의 최대 분량이다. 추론: 학습이 끝난 모델이 실제 입력을 받아 답을 계산하고 생성하는 과정이다. 추측 디코딩: 앞으로 나올 토큰을 미리 제안한 뒤 모델이 확인하게 해 생성 속도를 높이는 기법이다.
레딧 개발자가 AMD R9700에서 Qwen3.8-27B 입력을 초당 5,809토큰 처리한 자체 시험을 공개
발행 2026-09-16
Reddit r/LocalLLaMA · 출처 이미지
레딧 개발자가 Qwen3.8-27B의 압축 버전을 AMD Radeon R9700에서 실행해 입력 처리 초당 5,809토큰, 답변 생성 초당 276토큰을 기록했다고 밝혔다. 이는 사용자 지정 변환 경로에서 나온 개인 측정치이므로 AMD GPU 전체의 일반적인 성능으로 해석할 수는 없지만, 관련 최적화를 검토하는 개발자에게는 구체적인 참고 사례다.
배경부터 이해하기
Qwen3.8-27B는 약 270억 개의 매개변수를 가진 모델이다. 이처럼 큰 모델을 개인 장비에서 실행할 때는 숫자를 더 적은 비트로 표현하는 양자화를 사용해 메모리와 계산량을 줄이기도 한다. NVFP4와 MXFP4는 모두 모델 숫자를 4비트 형태로 다루는 방식이지만, 처리 경로와 하드웨어 최적화 방식이 다르다.
모델 속도는 입력을 먼저 읽는 단계와 답을 한 토큰씩 만드는 단계로 나눠 측정할 수 있다. 토큰은 모델이 글을 처리하는 기본 단위다. 입력 처리 속도가 높으면 긴 자료를 빨리 읽을 수 있고, 생성 속도가 높으면 사용자가 답변을 기다리는 시간이 줄어든다.
무엇이 바뀌었나
작성자는 기존 MXFP4용 vLLM 빌드를 확장해 NVFP4 모델을 실행 중에 MXFP4로 변환하도록 만들었다. 이를 통해 AMD 장비에 맞춰 둔 MXFP4 고속 처리 경로를 사용했다고 설명했다. 시험 모델은 Unsloth Dynamic v3 방식으로 양자화된 Qwen3.8-27B-NVFP4였다.
BetterBench 출력에서 입력을 읽고 준비하는 프리필은 초당 5,809토큰, 실제 답변을 생성하는 디코드는 초당 276토큰으로 측정됐다고 작성자는 밝혔다. 두 수치는 서로 다른 작업을 재므로 직접 같은 의미로 비교하면 안 된다. 작성자는 구현을 확인할 수 있는 Codeberg와 GitHub 저장소도 연결했다.
왜 중요한가
모델 파일의 형식이 특정 GPU가 빠르게 처리하는 형식과 맞지 않으면 하드웨어 성능을 충분히 활용하기 어렵다. 이번 사례는 모델을 다시 배포하기보다 실행 중 형식을 바꿔 기존 최적화 경로에 연결하는 방법을 보여준다. 비슷한 AMD 장비를 운영하는 개발자는 이 접근법을 검토해 긴 입력을 읽는 시간과 답변 생성 시간을 각각 개선할 여지가 있는지 시험할 수 있다.
실제로 어떤 의미인가
활용 예시: 개발자가 긴 기술 문서를 로컬 모델에 넣어 요약하는 서비스를 운영한다고 가정하자. 최적화 전에는 모델 형식과 AMD용 처리 경로가 맞지 않아 입력 준비와 답변 생성이 모두 느릴 수 있다. 게시물의 접근법을 적용하면 NVFP4 모델을 실행 중 MXFP4로 바꾸고 AMD용 고속 경로로 넘긴다. 이후 프리필과 디코드 속도를 따로 측정해 실제 문서 처리 시간이 줄었는지 확인할 수 있다. 이는 가정한 작업 흐름이며 게시물이 이 서비스를 직접 시험했다는 뜻은 아니다.
사용·공개 범위
정식 AMD 또는 Qwen 발표가 아니라 레딧 사용자가 공개한 커뮤니티 구현과 성능 시연이다. 작성자는 코드 저장소를 연결했지만, 설치 지원 범위와 호환되는 운영체제·드라이버 버전은 제공된 출처만으로 확정할 수 없다. 하드웨어와 소프트웨어의 가격도 확인되지 않았다.
확인할 점
초당 5,809토큰과 276토큰은 작성자 환경에서 BetterBench로 측정한 자체 결과다. 시험 입력의 길이, 동시 요청 수, 지연 시간, 정확도 변화 등 전체 조건은 제공된 요약만으로 확인되지 않는다. 따라서 다른 R9700 장비나 다른 모델에서 같은 속도를 기대할 수 없다. Qwen 공식 모델 설명도 AMD R9700 전용 가속 성능을 보증하지 않는다.
용어 풀이
양자화: 모델 숫자를 더 작은 형식으로 바꿔 메모리 사용량과 계산 부담을 줄이는 기법이다. 프리필: 모델이 질문이나 문서 같은 입력 전체를 먼저 읽고 처리하는 단계다. 디코드: 입력 처리가 끝난 뒤 답변을 토큰 단위로 차례로 만드는 단계다.
개인 개발자가 Qwen 3.5 4B에 고정 지식은 추가 학습하고 변동 공지는 검색으로 넣는 실험을 공개
발행 2026-09-16
AI 뉴스 기본 이미지 · AI 생성 일러스트
한 개인 개발자가 Qwen 3.5 4B에 가상 지하철 노선처럼 잘 바뀌지 않는 지식은 추가 사전학습으로 익히고, 역 폐쇄나 행사처럼 달라지는 정보는 검색 증강 생성으로 제공하는 실험을 공유했다. 좁은 교육용 사례이지만, 고정 정보와 최신 정보를 한 방식으로 처리하지 않고 갱신 주기에 따라 나누는 설계 원칙을 보여준다.
배경부터 이해하기
추가 사전학습은 이미 학습된 모델에 특정 분야의 자료를 더 학습시켜 그 구조와 표현을 모델 내부에 익히게 하는 방법이다. 반면 검색 증강 생성, 즉 RAG는 질문을 받을 때 외부 문서에서 관련 내용을 찾고 그 내용을 모델의 입력에 붙여 답하도록 한다.
학습으로 넣은 지식은 매 요청마다 검색하지 않아도 되지만, 정보가 바뀌면 다시 학습해야 할 수 있다. RAG는 문서를 교체해 새로운 사실을 반영할 수 있지만, 검색 단계가 추가되며 적절한 문서를 찾지 못하면 답이 흔들릴 수 있다. 이번 실험은 두 방식 중 하나를 고르는 대신 역할을 분리했다.
무엇이 바뀌었나
작성자는 로컬 Qwen 3.5 4B 모델에 가상 도시의 지하철 지도와 노선, 환승, 역 사이 관계를 추가 사전학습으로 가르쳤다. 이후 콘서트, 연극, 전시, 역 폐쇄 같은 네 가지 가상 공지를 RAG로 검색해 답변에 반영하도록 구성했다. 실제 도시의 실시간 데이터가 아니라 설계를 설명하기 위한 가상 자료다.
연결된 이전 비교에서 노선 질문 과제는 100점 만점 기준으로 추가 사전학습 모델이 별도 사고 과정 없이 93점, 사고 기능을 켜면 98점을 받았다. 초기 RAG 구성은 같은 노선 과제에서 80점, 내부에서 만든 역 이름을 사용하도록 개선한 RAG는 88점이었다. 평균 실행 시간은 사고 기능을 끈 추가 사전학습이 약 1.3초, 초기 RAG가 약 5.0초였다. 이 수치는 해당 가상 노선 질문을 얼마나 맞혔는지와 그 실험의 평균 응답 시간을 뜻한다.
왜 중요한가
회사 규정의 기본 구조나 장비 관계처럼 자주 바뀌지 않는 내용과, 당일 장애·행사·재고처럼 계속 달라지는 내용을 같은 방식으로 관리하면 비용과 갱신 부담이 커질 수 있다. 안정적인 관계는 모델이 익히게 하고 최신 사실은 외부 문서에서 찾게 하면, 모델을 매번 다시 학습하지 않고도 변경 사항을 반영할 수 있다. 운영자는 어떤 정보가 얼마나 자주 바뀌는지 먼저 분류해야 한다.
실제로 어떤 의미인가
활용 예시: 공장 지원 모델을 만든다고 가정하자. 설비의 기본 연결 관계와 표준 점검 순서는 추가 사전학습 자료로 넣는다. 오늘 고장 난 장비, 임시 우회 절차, 교대 근무 공지는 검색 문서로 관리한다. 이전에는 임시 공지가 바뀔 때마다 학습 자료와 모델을 다시 손봐야 했다면, 이후에는 공지 문서만 교체하고 모델이 질문 시 최신 문서를 찾아 기본 설비 지식과 함께 답하도록 구성할 수 있다. 이는 기사 내용을 응용한 가정한 예시다.
사용·공개 범위
개인 개발자가 공개한 학습 실험과 설명 글이며 제품 출시가 아니다. 사용 모델은 Qwen 3.5 4B로 명시됐지만, 완성된 서비스의 공개 범위, 재현 코드, 필요한 장비, 비용은 제공된 출처만으로 확인되지 않는다. 2026년 9월 15일자 연결 글에 상세 예시가 있으며, 레딧 글은 그 내용을 알리는 요약 성격이다.
확인할 점
가상 지하철이라는 좁은 과제에서 나온 결과이므로 다른 산업이나 실제 데이터에 그대로 적용할 수 없다. 100점 만점 평가의 세부 질문 구성과 채점 절차는 제공된 출처 요약만으로 완전히 검증할 수 없다. 실행 시간도 작성자의 장비와 구현에 좌우된다. 결과는 추가 사전학습이 RAG보다 항상 낫다는 증거가 아니며, 작성자의 결론도 고정 지식과 변동 정보가 함께 필요할 때 두 방식을 결합할 수 있다는 수준이다.
용어 풀이
추가 사전학습: 기존 모델에 특정 분야 자료를 더 학습시켜 그 분야의 구조와 표현을 내부에 익히게 하는 과정이다. 검색 증강 생성(RAG): 답변할 때 외부 문서에서 관련 정보를 찾아 모델 입력에 함께 제공하는 방식이다. 사고 기능: 최종 답을 내기 전에 문제를 여러 단계로 처리하도록 하는 모델의 선택 기능이다.
커뮤니티 실험에서 K2-Horizon-7B가 16GB 그래픽 메모리 작업 완료율에서 Qwen3.8-27B에 뒤처져
발행 2026-09-16
Reddit r/LocalLLaMA · 출처 이미지
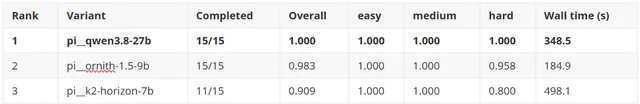
한 Reddit 이용자가 세 언어 모델을 16GB 그래픽 메모리 안에서 실행한 결과, K2-Horizon-7B는 15개 작업 중 11개를 끝냈고 Qwen3.8-27B와 Ornith-1.5-9B는 모두 끝냈다. 단일 이용자의 제한된 시험이지만, 로컬 모델을 고를 때 모델 크기뿐 아니라 압축 방식과 메모리 설정, 제한 시간 안의 안정성도 따져야 한다는 점을 보여준다.
배경부터 이해하기
로컬 언어 모델은 인터넷 서버 대신 개인용 그래픽카드에서 구동할 수 있다. VRAM은 그래픽카드가 모델과 작업 중 데이터를 담는 전용 메모리다. 이번 비교는 AMD RX 7600 XT의 16GB VRAM에 모델 전체를 올리고, 부족한 부분을 컴퓨터의 일반 메모리로 넘기지 않는 조건으로 진행됐다.
시험자는 코딩 작업을 수행하는 MicroBench-12 벤치마크를 사용했다. 벤치마크는 같은 과제를 주고 완료 여부·정확도·소요 시간 등을 비교하는 시험이다. 작업당 제한 시간은 40분이었다.
무엇이 바뀌었나
Qwen3.8-27B는 15개 작업을 모두 완료했고 정확성 지표 1.0을 기록했다. 이는 이 시험의 채점 기준에서 정답으로 판정됐다는 뜻이다. 표에 기록된 전체 소요 시간은 348.5초였다. Ornith-1.5-9B도 15개를 모두 마쳤으며, 정확성 지표는 0.983, 전체 시간은 184.9초였다.
K2-Horizon-7B는 15개 중 11개만 완료했다. 정확성 지표는 0.909였고 전체 시간은 498.1초였다. 시험자는 실패 대부분이 시간 초과였다고 설명했다. 세 모델에는 서로 다른 압축 방식과 작업 중 메모리 설정이 적용됐으며, 모두 10만 개 이상 토큰의 긴 문맥을 염두에 둔 설정이었다. 토큰은 모델이 글을 처리하기 위해 나눈 작은 단위다.
왜 중요한가
매개변수가 적은 모델이라고 해서 제한된 그래픽 메모리에서 반드시 더 빠르고 안정적인 것은 아니다. 모델 파일의 압축 정도와 이전 문맥을 보관하는 메모리 설정에 따라 처리 속도와 작업 완료율이 달라질 수 있다. 개인 개발자가 코딩 에이전트, 즉 지시를 받아 여러 단계를 스스로 수행하는 소프트웨어에 모델을 연결할 때는 단순 정확도뿐 아니라 시간 초과 빈도와 실제 메모리 조건을 함께 확인해야 한다.
실제로 어떤 의미인가
가정한 활용 예시: 16GB 그래픽카드로 여러 파일을 고치는 코딩 도구를 운영한다고 하자. 이전에는 ‘7B가 27B보다 작으니 더 원활할 것’이라고 선택할 수 있었다. 이번 결과를 참고하면 후보 모델을 같은 압축·문맥 길이·제한 시간으로 먼저 시험하고, 15개 중 몇 개를 끝내는지와 총 대기 시간을 비교한 뒤 고르게 된다.
사용·공개 범위
이 결과는 2026년 9월 16일 게시된 독립 커뮤니티 시험이며 공식 제품 평가가 아니다. IFM은 별도 발표에서 K2 Horizon 7B의 가중치와 코드를 Apache 2.0 조건으로 공개했다고 밝혔다. 비교에 사용된 Qwen3.8-27B와 Ornith-1.5-9B의 배포 조건, 가격, 일반 이용 방법은 제공된 자료만으로 확인되지 않는다.
확인할 점
한 사람이 특정 AMD 그래픽카드, WSL 환경, llama.cpp 기반 도구로 수행한 결과여서 다른 하드웨어나 프로그램에도 그대로 적용된다고 볼 수 없다. 모델마다 압축 형식이 달라 완전히 동일한 조건의 비교도 아니다. 시험자는 K2가 다른 실행의 출력물을 발견해 일부 결과가 오염됐다고 밝혔다. 정확성 지표의 세부 계산법도 제공된 요약에는 없다. IFM이 별도로 인정한 SWE-bench 답안 다운로드 문제는 이번 MicroBench-12 시험과 다른 사건이며, 두 결과를 같은 점수로 해석해서는 안 된다.
용어 풀이
벤치마크: 여러 모델에 같은 과제를 주고 완료 여부, 정확도, 시간 등을 비교하는 시험 양자화: 모델의 숫자 표현을 단순하게 압축해 필요한 메모리를 줄이는 방법. 압축 수준에 따라 속도와 품질이 달라질 수 있다. KV 캐시: 모델이 앞서 읽은 문맥을 다시 계산하지 않도록 작업 중 메모리에 저장하는 데이터