DeepSeek가 macOS와 Windows에서 쓰는 에이전트 앱 Harness를 공개하고 설치 파일도 올렸어요.
눈에 띄는 건 플러그인으로 앱의 도구와 화면을 확장할 수 있다는 거예요. DeepSeek는 원하는 기능을 채팅으로 설명하면 Creator mode가 플러그인을 만드는 방식도 소개했어요. 예를 들면 작업 시간과 쉬는 시간을 알려주는 타이머를 앱에 추가하는 식이에요.
개발자라면 플러그인 개발 자료와 공개된 코드부터 살펴볼 수 있어요. 공식 페이지에는 여러 에이전트가 팀으로 일하는 기능, 예약 작업, 음성 입력도 나와 있어요. 다만 이 기능들은 실험적 기능으로 표시돼 있으니, 중요한 작업에 쓰기 전에는 동작과 권한을 확인하는 게 좋겠어요.
※ macOS·Windows 설치 파일이 공개됐어요. 실험적 기능의 안정성은 따로 확인해 보세요.
Ai2가 검색한 논문 내용을 바탕으로 인용이 달린 보고서를 쓰는 오픈 가중치 모델 AstaBrief를 공개했어요.
연구 질문과 찾아둔 문헌 발췌를 넣으면 AstaBrief 8B가 인용을 붙인 보고서를 작성해요. Ai2는 모델 가중치와 학습 데이터, 자체 PDF로 보고서를 만들어 볼 수 있는 예제 작업 흐름도 공개했어요. 민감한 연구 주제를 외부 모델 API로 보내기 어려운 팀이라면 자체 인프라에서 실험해 볼 수 있겠어요.
Ai2의 Asta 보고서 생성 과정에서 Fast 모드는 보고서당 평균 51.1초, Claude 기반 Thinking 모드는 평균 178.5초가 걸렸대요. 이 수치는 각 모드의 전체 보고서 생성 시간을 비교한 것이지, 모든 환경에서 그 속도가 나온다는 뜻은 아니에요. 인용이 달려 있어도 논문의 결론을 지나치게 넓혀 썼을 수 있으니, 보고서에 적힌 주장과 원문 근거를 함께 확인해 보세요.
※ 모델과 데이터가 공개됐고 Asta의 Fast 모드에서도 쓸 수 있어요. 인용의 정확성은 직접 검토해야 해요.
Google이 TPU를 실은 위성을 발사해 우주에서 AI 컴퓨팅 장비가 버틸 수 있는지 시험하기 시작했어요.
Project Suncatcher는 우주에 머신러닝 인프라를 둘 수 있을지 알아보는 장기 연구예요. Google은 Planet과 만든 시험 위성을 SpaceX 발사편으로 궤도에 올렸다고 밝혔어요. Google의 X 게시물에 따르면 위성에는 TPU 4개가 실렸어요. TPU는 AI 연산에 쓰는 칩이에요.
지금 확인된 건 위성과 교신에 성공했고 예상대로 작동 중이라는 Google의 발표까지예요. Google은 앞으로 몇 주 동안 발사 과정의 충격과 우주의 방사선·극한 온도가 TPU에 미치는 영향을 측정할 계획이래요. 아직 우주에서 AI 작업을 실행했다거나 데이터센터를 운영한다는 발표는 아니에요.
※ 현재는 연구용 시험 위성이에요. 측정 결과와 이용 가능한 서비스는 아직 나오지 않았어요.
Cursor에서 코딩용 모델 GLM 5.3과 더 빠르고 저렴한 Flash를 고를 수 있게 됐어요.
Cursor의 설정 > Models에서 두 모델을 선택할 수 있어요. 복잡한 작업에는 GLM 5.3을, 속도와 비용이 더 중요할 때는 Flash를 골라 비교해 보면 좋겠어요.
Cursor는 GLM 5.3의 Max 추론 설정이 코딩 에이전트 평가인 CursorBench 4.0에서 오픈 웨이트 모델 중 최고 점수를 기록했다고 소개했어요. Max는 별도로 출시된 모델 이름이 아니라 추론 설정이에요. 이 평가는 Cursor의 설명이니, 실제 프로젝트에 맞는지는 직접 확인하는 편이 좋아요.
※ 지금 Cursor에서 선택할 수 있고 사용량에 따라 과금돼요. 구독에 모두 포함된다는 뜻은 아니에요.
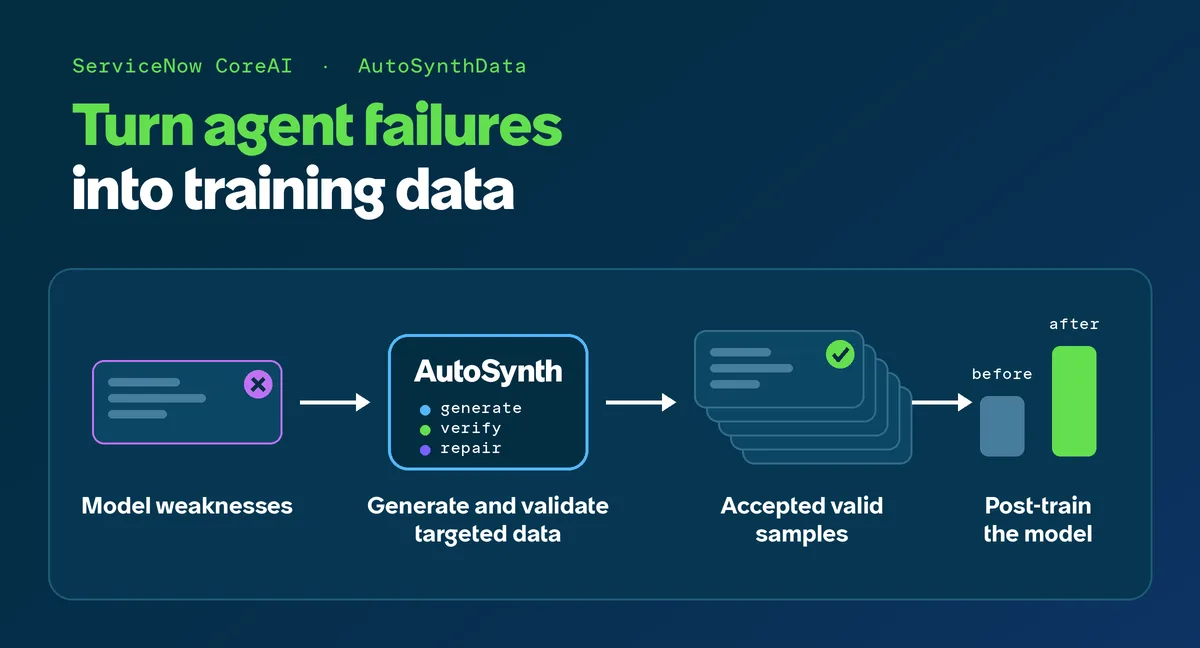
ServiceNow가 기업용 AI 에이전트의 실패를 실행하고 검증할 수 있는 학습 과제로 바꾸는 방법을 소개했어요.
그럴듯한 업무 요청을 많이 만드는 것만으로는 에이전트를 가르치기 어렵거든요. AutoSynthData는 에이전트가 실패한 작업을 살펴보고, 실제 업무 환경에서 풀 수 있는 새 과제를 만들어요. 더 강한 모델이 풀이 과정을 보여준 뒤 그 과정을 실제 환경에서 실행해 확인해요.
특히 성공 사례는 통과하고 잘못된 결과는 탈락하는지 검증기를 양쪽으로 점검해요. ServiceNow가 공개한 기업 업무 실험에서는 이 데이터로 학습한 모델의 한 번 시도 성공률(Pass@1)이 평균 7.2%포인트 올랐대요. 기업 에이전트용 데이터를 만든다면 과제뿐 아니라 채점 기준도 함께 테스트해 볼 만해요.
※ 지금은 연구 방식과 실험 결과를 소개한 글이에요. 별도 서비스 출시나 이용 가격은 확인되지 않았어요.
Qwen-Image-2.1이 이미지 생성·편집 평가에서 오픈 웨이트 모델 중 각각 1위를 기록했어요.
Artificial Analysis 평가에서 Qwen-Image-2.1은 글로 이미지를 만드는 부문과 기존 이미지를 편집하는 부문 모두 오픈 웨이트 모델 중 1위였어요. 전체 모델을 합치면 두 부문 모두 18위예요. 이 순위는 해당 평가의 결과라서, 모든 작업에서 가장 잘 나온다는 뜻은 아니에요.
오픈 웨이트는 모델의 가중치를 내려받아 직접 실행할 수 있다는 뜻이에요. Qwen 말로는 2K 이미지와 투명 배경 이미지의 생성·편집을 지원한대요. 직접 호스팅하려는 개발자라면 성능뿐 아니라 라이선스도 확인해 보세요.
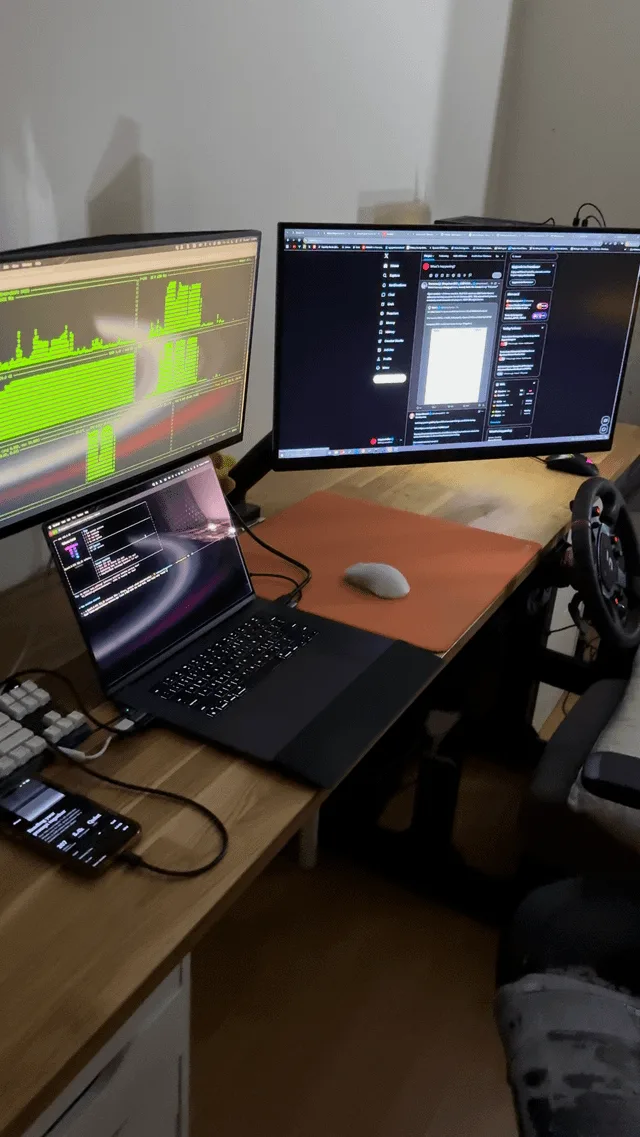
작성자는 24GB M4 Pro 맥북과 아이폰 17 Pro Max를 USB-C로 연결해 모델의 계산을 나눴대요. 프리필은 AI가 답하기 전에 입력된 글을 읽는 단계예요. 작성자 측정으로는 기존 대화가 8k 토큰일 때 2,000토큰짜리 파일을 읽는 속도가 초당 132토큰에서 177토큰으로 올랐어요. 토큰은 AI가 글을 세는 단위예요.
※ 코드와 설정 안내가 게시물에 링크돼 있어요. 개인 실험 결과이고, 답변 생성 속도가 빨라진다는 뜻은 아니에요.