Anthropic은 Claude를 이용해 단백질 구조 예측과 설계 등에 쓰이는 오픈소스 생물분자 모델 30여 개를 최적화하고, 그 코드를 공개했다. 회사 측 시험에서는 작업 속도가 평균 약 4배로 높아졌고 대형 분자 시스템도 한 대의 GPU 서버에서 처리할 수 있어, 연구에 필요한 시간과 컴퓨팅 자원을 줄일 가능성이 있다.
배경부터 이해하기
생물분자 모델은 아미노산 배열로 단백질의 3차원 구조를 예측하거나, 원하는 기능을 갖는 단백질을 설계하는 과학용 소프트웨어다. 신약 후보 탐색, 유전체 분석, 단백질 기능 연구 등에 쓰인다. 추론은 이미 학습된 모델이 새 입력을 받아 예측 결과를 만드는 과정이다.
큰 분자 구조를 계산할 때는 세 분자 요소의 관계를 함께 처리하는 연산이 시간과 메모리를 많이 사용한다. Anthropic 설명에 따르면 분석 대상의 크기가 두 배가 되면 일부 핵심 연산의 시간과 메모리 사용량은 여덟 배가 될 수 있다. 이전 단백질 설계 실험에서는 표적 하나당 최대 2,500시간 상당의 NVIDIA H100 GPU 연산을 허용해 대부분의 연구자가 감당하기 어려운 규모였다고 회사는 밝혔다.
무엇이 바뀌었나
Claude는 약 4주 동안 기술 직원 2명의 감독 아래 구조 예측, 단백질 설계, 유전체 분석 등 30여 개 오픈소스 모델의 코드를 손봤다. 중복 계산을 저장해 다시 쓰고, 결과가 정해진 불필요한 코드 경로를 단순화했으며, GPU가 핵심 연산을 효율적으로 처리하도록 저수준 코드를 제작했다. 전체 작업은 정밀도 손실을 최소화한 설정에서 평균 약 4배 빨라졌고, 출력이 완전히 같은 설정에서는 거의 2배 빨라졌다는 것이 Anthropic의 종합 주장이다. 구조 예측 모델 12개 이상만 보면 출력이 같은 경우 평균 약 1.6배 빨라졌다.
새 저메모리 ‘Big’ 모드는 아미노산, 핵산, 작은 분자의 원자 등을 세는 입력 단위인 토큰이 1만 개를 넘는 시스템을 NVIDIA GPU 서버 한 대에서 정확하게 예측했다. 최대 7만 개가 넘는 시스템도 한 대의 8-GPU B300 서버에서 계산 자체는 끝냈지만, 이 초대형 결과는 실제 구조와 맞지 않고 무너졌다. Anthropic은 최적화된 코드를 오픈소스로 공개했다. Adaptyv Bio와 함께 5개 과제를 다루는 단백질 설계 대회도 발표했으며, 5,000개가 넘는 제출 설계의 실험실 검증을 지원한다고 밝혔다.
왜 중요한가
연구 모델이 네 배 빨라졌다는 말은 같은 종류의 예측 작업을 처리하는 속도가 기존의 약 네 배가 됐다는 뜻이다. 단순화하면 기존에 네 시간이 걸리던 계산이 비슷한 조건에서 약 한 시간 수준이 될 수 있지만, 실제 시간은 모델과 장비, 정확도 설정에 따라 달라진다. 메모리 절감은 여러 GPU 서버가 필요했던 큰 분자 시스템을 서버 한 대에서 시험할 길을 넓힌다. 연구팀은 장비 대기와 비용 부담을 줄이고 더 많은 후보 구조를 비교할 수 있다. 코드가 공개됐기 때문에 다른 개발자가 구현을 검토하거나 자신의 연구 도구에 적용할 수도 있다.
실제로 어떤 의미인가
활용 예시: 한 대학 연구팀이 특정 단백질에 붙는 후보 단백질 100개를 구조 예측 모델로 평가한다고 가정하자. 이전에는 연산 시간이 길어 후보 수를 줄이거나 여러 GPU 서버를 확보해야 했을 수 있다. 공개된 최적화 코드가 해당 모델과 장비에서 제대로 작동한다면, 연구팀은 같은 시간에 더 많은 후보를 계산하고 유망한 일부만 실제 실험으로 넘길 수 있다. 다만 이는 이해를 돕기 위한 가정이며, 해당 100개 후보 작업을 Anthropic이 실제 시험했다는 뜻은 아니다.
사용·공개 범위
최적화된 모델 코드는 발표 당일 오픈소스로 공개됐다. 이용자는 공개 저장소에서 코드를 확인할 수 있으나, 지원되는 모델별 설치 조건과 필요한 NVIDIA GPU 종류는 원문에 일괄적으로 명시되지 않았다. 단백질 설계 대회는 최대 100만 달러 상당의 Claude 이용 크레딧, 최대 25만 달러 상당의 Modal 컴퓨팅 크레딧과 5,000개 이상 설계의 실험 검증을 지원한다고 발표됐다. 참가 자격, 신청 일정과 선정 조건은 별도 대회 안내에서 확인해야 하며 현금 지급으로 소개된 것은 아니다.
확인할 점
속도와 정확도 수치는 Anthropic이 자사 환경에서 측정한 회사 주장이다. 평균 약 4배 향상은 일부 정밀도 감소를 허용한 설정을 포함하며, 완전히 같은 출력을 요구하면 향상 폭이 더 작다. 모델과 GPU 구성에 따라 결과가 달라질 수 있다. 1만 토큰이 넘는 일부 시스템은 실험으로 확인된 구조와 가깝게 예측됐지만, 3만1,000~7만 토큰대 초대형 시스템은 계산만 완료됐을 뿐 정확한 구조를 만들지 못했다. 컴퓨터상 결합 평가가 비슷했다는 결과도 실제 생물 실험에서 효능이나 안전성이 확인됐다는 의미는 아니다.
용어 풀이
추론: 학습이 끝난 AI 모델에 새 데이터를 넣어 구조나 성질 같은 결과를 계산하는 과정. 토큰: 이 연구에서 모델이 입력을 세는 단위. 아미노산, 핵산, 작은 분자의 원자와 이온 등을 포함한다. GPU: 많은 계산을 동시에 처리해 AI와 과학 모델 실행을 빠르게 하는 연산 장치.
Anthropic, 검증된 생명과학 팀에 규제를 조정한 Claude를 제공하는 LSVP 베타 공개
발행 2026-09-17
Anthropic 공식 로고
Anthropic은 검증을 통과한 생명과학 팀과 기관이 Mythos·Opus·Sonnet 모델을 연구에 이용하도록 하는 Life Sciences Verification Program을 베타로 공개했다. 일반 서비스보다 생물학 관련 요청을 폭넓게 허용하는 대신 신청 조직과 연구 목적을 확인하고 관련 데이터를 30일 보관해 사후 감시하므로, 접근 확대와 안전 통제를 함께 적용하는 제도다.
배경부터 이해하기
생명과학 연구에는 신약 탐색, 기초 생물학, 임상 개발, 제조처럼 정상적인 목적이지만 위험한 생물학 정보와 겹칠 수 있는 작업이 있다. Anthropic의 일반 제공 모델인 Fable에서는 이런 요청 중 일부가 차단될 수 있다. LSVP는 연구자의 자격과 관리 체계를 확인한 뒤 더 강한 Claude 모델에 별도 접근 권한을 주는 프로그램이다.
API는 다른 소프트웨어가 Claude에 요청을 보내고 답을 받게 하는 연결 방식이다. LSVP 권한은 Claude Science, Claude.ai, Claude Code와 API에서 이용하도록 설계됐다. 프로그램 도입 전부터 수십 개 조직이 조기 접근 과정에 참여했다고 Anthropic은 밝혔다.
무엇이 바뀌었나
LSVP에는 Standard Use와 High-risk Use 두 권한이 있다. Standard Use는 대다수 생명과학 연구와 개발을 위한 팀 단위 권한이다. Mythos 5.1, Opus 5, Sonnet 5와 향후 출시 모델에 적용되며 1년마다 갱신한다. 신청자는 연구 경력, 보안 기준, 윤리적 연구 감독 체계에 대한 검토를 받는다.
High-risk Use는 Standard Use에서 막히는 특정 프로젝트를 위한 추가 권한이다. 생명과학 요청을 차단하는 안전장치를 제거하지만 사이버 보안 등 다른 분야의 안전장치는 유지한다. 프로젝트별로 부여되고 6개월마다 갱신한다. Opus 5와 Sonnet 5용 고위험 권한은 제공되지만, Mythos용 권한은 추가 심사를 받은 소수 기관으로 제한된다. 실시간 차단 대신 여러 요청의 행동 패턴을 사후 분석하며, 이를 위해 LSVP 이용 데이터를 30일 보관한다. 해당 데이터는 모델 학습에 쓰지 않고 Anthropic 생명과학 연구팀도 접근할 수 없다고 회사는 설명했다.
왜 중요한가
정상적인 연구 요청이 개별 문장만 보면 위험한 요청처럼 보일 때 실시간 차단이 반복되면 연구 흐름이 끊길 수 있다. LSVP는 사전에 조직과 목적을 확인하고, 승인 범위를 벗어나는 활동이 이어지는지 여러 이용 기록을 종합해 살핀다. 이에 따라 승인된 연구자는 허용 범위에서 중단을 덜 겪을 수 있다. 반면 조직 관리자는 계정 탈취, 내부자의 악용, 에이전트의 예상 밖 행동에 대응해야 한다. 여기서 에이전트는 목표를 받아 여러 단계를 스스로 수행하는 AI 시스템을 뜻한다. 이상 활동이 포착되면 관리자는 미리 정한 시간 안에 조사하고 조치해야 한다.
실제로 어떤 의미인가
가정한 예시: 제약회사 연구팀이 특정 바이러스 전달체가 사람의 면역 반응에 어떻게 인식되는지 분석한다고 하자. 이전에는 관련 질문 일부가 일반 안전장치에 막혀 작업을 나눠 진행해야 했을 수 있다. LSVP에서 팀은 일상 분석에 Standard Use를 쓰고, 승인받은 특정 이중용도 프로젝트에는 High-risk Use를 적용할 수 있다. Anthropic은 요청 패턴이 신청서에 적은 연구 범위를 벗어나는지 사후 확인하고, 문제가 보이면 조직 관리자에게 알린다. 이는 운영 방식의 이해를 돕기 위한 예시이며 실제 고객 사례가 아니다.
사용·공개 범위
LSVP는 발표 시점에 베타로 공개됐으며 생명과학 팀과 기관의 신청을 받는다. Anthropic의 자체 API 콘솔과 Claude Enterprise 및 Team 요금제에서 이용할 수 있다. 개인용 Pro와 Max 요금제, 외부 사업자의 플랫폼에서는 아직 지원하지 않는다. 의료정보 보호 계약인 BAA가 적용된 조직도 베타 대상이 아니므로, 보호 대상 건강정보를 처리하는 용도로는 사용할 수 없다. 가격과 별도 프로그램 이용료는 원문에서 확인되지 않았다. Anthropic은 첫 주에 수백 개 조직을 등록할 것으로 예상한다고 밝혔지만 이는 보장된 규모나 마감일이 아니다.
확인할 점
베타 서비스이므로 기능과 접근 범위가 바뀔 수 있다. Claude.ai와 Claude Code에서는 처음에 미리 선택된 기본 권한 하나만 적용되며, API 인증을 쓰는 Claude Code는 예외다. 30일 데이터 보관과 사후 감시는 정상 연구의 차단을 줄이는 대신 개인정보, 기밀 유지와 조직 내부 통제에 대한 검토를 요구한다. High-risk Use가 모든 안전장치를 없애는 것은 아니며 생명과학 요청 차단 외의 통제는 남는다. Anthropic은 감시가 악용을 완전히 막는다고 입증한 수치나 외부 평가 결과를 제시하지 않았다.
용어 풀이
API: 회사의 프로그램이나 연구 도구가 Claude에 자동으로 요청을 보내도록 연결하는 통로. 에이전트: 사람이 정한 목표를 바탕으로 검색, 분석, 도구 사용 같은 여러 단계를 스스로 수행하는 AI. 이중용도 연구: 질병 치료 같은 유익한 목적과 해로운 생물학적 악용 가능성을 동시에 가진 연구.
UN 시스템과 Google은 여러 UN 기관에 흩어진 세계 통계를 연결해 일반 문장으로 검색할 수 있는 UN System Data Commons를 출시했다. 연구자와 기자, 정책 담당자는 서로 다른 형식의 자료를 수작업으로 합치는 시간을 줄일 수 있지만, 중요한 수치를 인용하기 전에는 원자료를 직접 확인해야 한다.
배경부터 이해하기
UN 산하 기관들은 보건, 교육, 빈곤, 전기와 식수 접근성 등 세계 각지의 통계를 수집한다. 하지만 자료가 기관별 저장소에 나뉘고 형식, 지역 구분, 조사 시점이 서로 달라 여러 분야를 함께 분석하려면 표를 내려받아 수작업으로 정리해야 했다. Google은 이 준비 작업에 수개월이 걸리는 경우도 있었다고 설명했다.
UN System Data Commons는 Google의 Data Commons 기술을 바탕으로 만든 오픈소스 플랫폼이다. 서로 다른 자료의 지표, 시간, 지역 정보를 연결된 구조로 정리한다. 이런 구조를 지식 그래프라고 하며, 사람·장소·통계 같은 항목과 그 관계를 연결해 검색과 비교가 쉽도록 만든 데이터 체계다.
무엇이 바뀌었나
사용자는 data.un.org에서 일상적인 문장으로 질문하고 관련 통계와 대화형 시각화를 받을 수 있다. 예를 들어 지난 10년간 전기를 이용할 수 있게 된 인구나 지역별 기대수명의 변화를 물을 수 있다. 직접 둘러보기를 원하면 Explore 메뉴에서 지역, 보건, 교육 같은 조건으로 자료를 걸러볼 수 있다. 플랫폼에 들어가는 각 데이터 세트는 UN 통계 담당자와 기술 전문가의 확인을 거친다고 Google은 밝혔다.
AI 연구 도우미와 연결하는 기능도 포함됐다. AI 에이전트는 사용자의 목표에 따라 여러 단계를 수행하는 프로그램이다. 공개 연결 표준인 MCP를 이용하면 이런 도우미가 UN System Data Commons에서 수치를 가져오고 서로 다른 분야의 관계를 찾아 차트, 그래프, 정보 그림이나 보고서 초안을 만들 수 있다. UN 시스템은 2027년까지 전체 UN 통계 데이터 세트의 80%를 포함하는 것을 목표로 앞으로 1년 동안 참여 기관의 자료를 더 추가할 계획이다. 80%는 전 세계 모든 통계가 아니라 UN 시스템이 보유한 통계 데이터 세트 가운데 플랫폼에 포함하려는 비율이다.
왜 중요한가
기존에는 국가명과 연도 표기를 맞추고 여러 스프레드시트의 열을 정리한 뒤에야 본격적인 분석을 시작할 수 있었다. 새 플랫폼은 공통 지역과 시점에 따라 자료를 연결해 이 준비 단계를 줄인다. 비영리단체 담당자는 사업 지역의 보건·교육 지표를 함께 살필 수 있고, 기자는 질문형 검색으로 관련 자료의 위치를 빠르게 찾을 수 있다. 개발자는 AI 도구가 출처가 불분명한 숫자를 만들어 내도록 두는 대신 UN 자료를 직접 불러오도록 연결할 수 있다. 다만 데이터 연결이 쉬워지는 것이 통계의 인과관계까지 자동으로 증명해 주는 것은 아니다.
실제로 어떤 의미인가
활용 예시: 한 비영리단체가 농촌의 깨끗한 식수 접근성과 학교 출석 사이의 관계를 조사한다고 가정하자. 이전에는 두 지표를 담당하는 기관의 파일을 각각 찾아 국가와 연도를 맞추고 하나의 표로 합쳐야 했다. 이제 담당자는 자연어로 질문해 관련 통계와 시각화를 먼저 확인하고, 필요한 지역과 기간을 좁힌 뒤 보고서 초안을 만들 수 있다. 마지막 단계에서는 각 그래프가 가리키는 UN 원자료와 정의를 확인해야 한다. 이는 가능한 작업 흐름을 설명한 가정이며, 플랫폼이 두 지표의 인과관계를 실제로 입증했다는 뜻은 아니다.
사용·공개 범위
UN System Data Commons는 출시됐으며 data.un.org에서 공개적으로 탐색할 수 있다. 오픈소스 플랫폼으로 소개됐지만 원문은 이용료, 국가별 접속 조건이나 개발자용 사용 한도를 구체적으로 밝히지 않았다. 현재 모든 UN 통계가 들어간 것은 아니다. 추가 데이터는 향후 1년 동안 단계적으로 포함될 예정이며, 2027년 80% 수치는 확정된 완료 결과가 아니라 UN 시스템의 목표다.
확인할 점
Google이 소개한 자연어 답변과 시각화도 질문 해석, 지표 선택 또는 기간 설정이 잘못될 수 있다. 회사 역시 중요한 수치를 인용하기 전에 연결된 원출처를 검토하라고 권고한다. UN 전문가가 데이터 세트를 확인하더라도 국가별 조사 방식과 통계 정의가 완전히 같다는 의미는 아니다. 플랫폼이 보여 주는 두 추세가 함께 움직인다고 해서 하나가 다른 하나의 원인이라는 결론을 바로 내릴 수도 없다. AI가 만든 보고서 초안과 그래프에는 사람의 검토가 필요하다.
용어 풀이
지식 그래프: 서로 다른 데이터 항목과 그 관계를 연결해 검색과 비교가 쉽도록 정리한 구조. AI 에이전트: 목표를 받아 자료 검색, 비교, 차트 작성 같은 여러 단계를 이어서 수행하는 AI 프로그램. MCP: AI가 외부 데이터와 도구에 정해진 방식으로 연결되도록 돕는 공개 연결 규격.
OpenAI, 선정된 로펌에 미국 법률 조사·문서 작성 도구 ‘Astra for Law’ 제공
발행 2026-09-17
OpenAI 공식 로고
OpenAI가 미국 법률 자료 검색, 분석, 초안 작성과 기밀성 관리를 한곳에 묶은 ‘Astra for Law’를 공개하고 우선 선정된 로펌에 제공한다. 일반 웹 검색보다 법률 자료에 맞춘 검색 체계와 관리 기능을 결합해 조사 결과의 정확성과 내부 데이터 통제를 높이려는 제품이다.
배경부터 이해하기
Astra for Law는 로펌과 법률 기술 회사를 위한 법률 업무용 인공지능 제품이다. 판례나 법령을 조사하고, 분석 결과를 정리하며, 문서 초안을 만드는 과정을 지원한다.
법률 업무에서는 답변 자체뿐 아니라 근거 자료의 출처와 기밀 문서의 처리 방식이 중요하다. 이 제품은 범용 인공지능 모델에 법률 검색 자료, 글쓰기 지침, 조직 관리 기능을 결합하는 방식으로 구성됐다.
무엇이 바뀌었나
OpenAI는 GPT-6 Astra를 기반으로 미국 판례, 법령, 규정, 법원 규칙과 행정 결정을 검색하는 색인을 추가했다. 이 색인은 2억3천만 개가 넘는 웹주소를 다루며 자료가 매일 추가된다고 회사는 설명했다. Free Law Project와 CourtListener를 통해 공개된 미국의 선례 가치가 있는 판례 가운데 99.9% 이상도 포함한다고 밝혔다.
OpenAI는 비공개 법률 조사 평가 세트의 미국 법률 질문 200개로 제품을 시험했다. 전체 Astra for Law 구성이 질문의 답과 근거가 전반적으로 정확한지를 판정하는 검사에서 54.0%를 통과했고, GPT-6 Astra가 일반 웹 검색만 사용했을 때는 38.7%를 통과했다고 보고했다. 두 수치는 정답률이 15.3%포인트 높아졌다는 뜻이며, 독립 기관이 재현한 결과는 아니다.
왜 중요한가
법률팀은 일반 검색 결과를 다시 판례 데이터베이스와 대조하고, 찾은 근거를 문서 작성 도구로 옮기는 데 시간이 든다. 검색과 분석, 작성 지침을 연결하면 이런 이동과 반복 작업을 줄일 수 있다. 별도의 기밀성·조직 관리 기능은 직원이 민감한 의뢰인 자료를 다룰 때 회사 정책에 맞는 사용 환경을 구성하는 데 도움이 될 수 있다.
실제로 어떤 의미인가
활용 예시: 변호사가 특정 미국 규정과 관련된 판례를 조사한다고 가정할 수 있다. 기존에는 여러 검색 결과에서 적용 가능한 판례를 골라 출처를 정리한 뒤 의견서 초안에 따로 옮겼다면, Astra for Law에서는 법률 검색 결과를 바탕으로 쟁점별 분석과 초안 작성을 이어갈 수 있다. 이는 사용 흐름을 설명하기 위한 가정이며 실제 사건에서 검증된 사례는 아니다.
사용·공개 범위
발표 시점에는 ‘Trusted Access’를 통해 선정된 로펌만 ChatGPT와 Codex에서 이용할 수 있다. 모델 선택 화면에는 ‘GPT-6 Astra Law’로 표시된다. API는 다른 프로그램이 모델을 호출하는 연결 방식이며, ‘gpt-6-astra-law’라는 이름으로 곧 제공될 예정이지만 정확한 날짜와 가격은 확인되지 않았다. 자격을 갖춘 조직에는 API의 입력·출력을 보관하지 않는 설정과, ChatGPT Enterprise 데이터를 기본적으로 사람의 검토 대상에서 제외하는 설정이 제공된다고 OpenAI는 밝혔다.
확인할 점
검색 범위와 평가 결과는 OpenAI가 자체 발표한 수치다. 평가는 비공개 검증 세트의 미국 법률 질문 200개에 한정됐으며, 다른 국가의 법률이나 실제 사건에서 같은 성능이 나온다는 근거는 제시되지 않았다. 54.0% 통과율은 모든 답이 정확하다는 뜻이 아니므로, 법률 전문가가 원문과 인용 근거를 확인해야 할 여지가 크다.
용어 풀이
법률 검색 색인: 판례·법령 같은 자료를 빠르게 찾도록 출처와 내용을 정리한 검색용 목록이다. API: 한 프로그램이 다른 프로그램의 기능이나 모델을 자동으로 호출하는 연결 방식이다. Zero Data Retention: API로 보낸 입력과 생성된 출력을 서비스 제공자가 보관하지 않도록 하는 설정이다.
FreedomIntelligence, 의료용 HuatuoGPT-3-9B 모델과 학습 코드·데이터 공개
발행 2026-09-18
Reddit · r/LocalLLaMA · 출처 이미지
FreedomIntelligence가 Qwen3.5-9B를 의료 분야에 맞게 조정한 HuatuoGPT-3-9B와 함께 학습 코드, 의료 학습 데이터, 평가 도구를 공개했다. 완성된 모델만 제공하는 것이 아니라 재학습과 검토에 필요한 구성 요소도 배포해 개발자가 의료 특화 모델의 제작 방식을 재현하거나 응용할 수 있게 한 점이 핵심이다.
배경부터 이해하기
HuatuoGPT-3-9B는 의료 질문에 답하고 관련 추론을 수행하도록 만든 언어 모델이다. 이름의 ‘9B’는 모델 안에서 학습되는 수치 요소가 약 90억 개 규모라는 뜻이며, 성능이나 정확도가 90억 점이라는 의미는 아니다.
이 모델은 Qwen3.5-9B를 바탕으로 한다. 프로젝트는 의료 분야에 적응시키기 위해 OnePO라는 단일 강화학습 단계를 사용했다고 설명한다. 강화학습은 모델이 만든 답을 평가하고 그 결과를 이용해 더 적절한 답을 내도록 조정하는 방식이다.
무엇이 바뀌었나
공개 패키지에는 HuatuoGPT-3-9B의 모델 파일뿐 아니라 학습 코드, 의료 강화학습 데이터 세트와 80억 개 규모의 평가 모델이 포함됐다. 이 평가 모델은 정해진 기준표에 따라 답변을 채점하는 ‘rubric grader’ 역할을 한다. 같은 계열에는 8B와 32B 모델도 있다고 문서에 적혀 있다.
프로젝트 설명에 따르면 OnePO는 의료 분야의 정답 예시로 먼저 지도 미세조정을 하는 별도 단계 없이, 한 번의 강화학습 단계로 분야 적응을 수행한다. 실제 실행 시에는 모델이 답을 만들기 전에 중간 추론을 수행하는 ‘thinking mode’를 켜야 하며, 문서는 enable_thinking=True 설정을 유지하라고 안내한다.
왜 중요한가
개발자는 공개된 모델만으로 결과를 사용하는 데 그치지 않고, 코드와 데이터를 살펴보며 의료 분야 학습 절차를 재현하거나 다른 전문 분야에 맞게 수정할 수 있다. 평가 모델까지 함께 제공되므로 생성된 답을 일정한 기준으로 자동 채점하는 실험도 구성할 수 있다. 다만 공개 범위가 넓다는 사실과 실제 의료 환경에서 안전하고 정확하다는 것은 별개의 문제다.
실제로 어떤 의미인가
가정한 예시: 연구팀이 의료 상담 문답 모델을 시험한다고 하자. 모델 파일만 있다면 질문을 넣고 답을 확인하는 데 그치지만, 이번 패키지에서는 공개 데이터와 코드를 이용해 학습 과정을 다시 실행하고 평가 모델로 답변을 채점할 수 있다. 이후 사람이 오답 유형을 검토해 학습 자료를 수정할 수 있다. 이는 작업 흐름을 설명한 예시이며 실제 진료나 임상 시험 사례가 아니다.
사용·공개 범위
HuatuoGPT-3-9B의 모델 파일, 코드와 관련 자료가 Hugging Face를 통해 공개된 것으로 안내됐다. Apache-2.0 라이선스가 적용된다. Transformers, vLLM, SGLang과 Docker Model Runner를 이용한 실행 예시가 문서에 포함됐다. 별도 유료 서비스의 제공 여부와 운영 비용은 확인되지 않았다.
확인할 점
세부 기능과 학습 방식에 관한 강한 주장은 프로젝트 자체 모델 설명서에서 나온 것이다. 제공된 자료에는 임상 현장의 진단 정확도, 환자 안전성 또는 의료진과의 비교 결과가 제시되지 않았다. thinking mode를 반드시 켜야 한다는 실행 조건이 있으며, 모델 크기와 BF16 형식에 맞는 컴퓨팅 자원도 필요할 수 있지만 구체적인 최소 장비 사양은 확인되지 않았다.
용어 풀이
강화학습: 모델이 만든 결과를 평가한 뒤 더 좋은 결과가 나오도록 학습 방향을 조정하는 방식이다. 추론: 학습이 끝난 모델에 질문을 넣어 실제 답을 생성하는 실행 과정이다. 지도 미세조정: 사람이 준비한 질문과 모범 답안 예시를 이용해 기존 모델을 특정 분야에 맞게 추가 학습하는 과정이다.
Tencent가 문서 페이지 이미지를 구조화된 Markdown 문서로 변환하는 WeVisDoc-2B와 WeVisDoc-4B를 공개했다. 일반 텍스트뿐 아니라 수식과 표의 형식을 보존하도록 설계돼 스캔 문서의 검색·편집용 데이터 변환 과정을 단순화할 수 있다.
배경부터 이해하기
문서 파서는 이미지에 있는 글자만 읽는 데서 그치지 않고 제목, 문단, 수식과 표의 구조를 구분해 편집 가능한 형태로 바꾸는 도구다. WeVisDoc는 한 페이지 이미지를 입력받아 문서 구조를 표시할 수 있는 간단한 텍스트 형식인 Markdown으로 출력한다.
WeVisDoc-2B와 4B는 이미지와 글을 함께 처리하는 Qwen3-VL-2B-Instruct와 Qwen3-VL-4B-Instruct를 각각 문서 처리에 맞게 추가 학습한 모델이다. 수식은 LaTeX 표기법으로, 표는 웹 문서에서 쓰는 HTML 형식으로 보존하도록 만들어졌다.
무엇이 바뀌었나
Tencent는 20억 개 규모와 40억 개 규모의 두 모델을 Hugging Face에 공개했다. 두 모델 모두 페이지 전체를 한 번에 구조화된 문서로 바꾸는 방식이며, 일반 대화나 이미지 설명이 아니라 문서 해석에 초점을 맞춘다. 배포 파일은 safetensors 형식이고 Apache-2.0 라이선스가 적용된다.
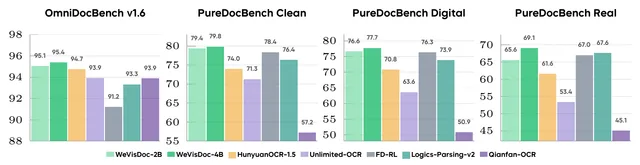
Tencent의 자체 평가표에서 4B 모델은 페이지 이미지의 문서 구조 복원 능력을 평가하는 OmniDocBench v1.6에서 95.38점, PureDocBench의 세 가지 문서 처리 부문을 합산한 평균에서 75.54점을 기록했다. 2B 모델은 같은 과제에서 각각 95.06점과 평균 73.86점을 기록했다. 회사는 비교표에 포함된 종단 간 문서 파서 가운데 4B 모델이 네 가지 보고 조건 모두에서 1위였다고 밝혔다.
왜 중요한가
스캔한 보고서나 논문을 검색 가능한 자료로 만들 때 글자 인식, 표 복원, 수식 변환을 각각 처리하면 단계마다 오류가 생길 수 있다. 한 모델이 페이지 구조와 여러 요소를 함께 출력하면 후속 검색 시스템이나 문서 편집 과정에 넘길 데이터를 더 단순한 흐름으로 만들 수 있다. 작은 2B 모델과 더 큰 4B 모델이 함께 제공돼 개발자가 필요한 규모를 선택해 시험할 수도 있다.
실제로 어떤 의미인가
활용 예시: 개발자가 수식과 표가 섞인 연구 보고서를 내부 검색 자료로 만든다고 가정하자. 기존에는 페이지에서 글자를 추출한 뒤 표를 다시 만들고 수식을 별도로 입력해야 했다면, WeVisDoc에는 PDF의 각 페이지를 이미지로 바꿔 넣고 Markdown 본문, LaTeX 수식과 HTML 표를 한 번에 받을 수 있다. 이는 가능한 작업 흐름을 설명한 가정이며 실제 문서에서 검증된 사례는 아니다.
사용·공개 범위
WeVisDoc-2B와 WeVisDoc-4B의 모델 파일이 Hugging Face에 공개됐다. 로컬 Transformers 또는 vLLM을 이용한 빠른 실행 방법이 안내돼 있다. Hugging Face에서 즉시 호출할 수 있는 외부 추론 서비스에는 현재 배포되지 않았으며, 가격 정보도 확인되지 않았다. 입력은 원본 PDF가 아니라 페이지 이미지여야 한다.
확인할 점
성능 점수와 1위 주장은 Tencent가 선택한 평가 과제와 비교 대상에 따른 회사 측 결과다. 95.38점과 75.54점은 서로 다른 문서 처리 평가에서 나온 점수이므로 정확도 백분율로 단순 비교할 수 없다. 실제 성능은 문서 언어, 스캔 품질, 복잡한 표와 수식 구성에 따라 달라질 수 있지만, 제공된 자료에는 이런 조건별 상세 결과가 제시되지 않았다.
용어 풀이
문서 파서: 문서 이미지에서 글자뿐 아니라 제목, 문단, 표와 수식의 구조까지 찾아 편집 가능한 데이터로 바꾸는 도구다. Markdown: 제목, 목록과 표 같은 문서 구조를 간단한 기호로 표시하는 텍스트 형식이다. 종단 간 처리: 여러 중간 도구를 따로 거치지 않고 입력부터 최종 결과까지 한 모델이 처리하는 방식이다.
Cactus Compute, 기기 안에서 함수 호출을 만드는 8~29MB Needle 3 공개
발행 2026-09-18
Reddit · r/LocalLLaMA · 출처 이미지
Cactus Compute는 사용자의 요청과 앱의 함수 목록을 받아 실행할 함수와 인자를 구조화된 형태로 만드는 소형 자동화 모델 Needle 3를 공개했다. 인터넷 연결 없이 휴대전화나 소형 기기에서 자동화 기능을 구현할 수 있는 후보이며, 모델과 코드, 파이썬 패키지, 브라우저 체험 환경이 함께 배포됐다.
배경부터 이해하기
Needle 3는 대화를 길게 이어가는 챗봇보다 앱 조작과 정보 추출에 초점을 맞춘 모델이다. 예를 들어 앱이 ‘일정 추가’ 함수의 이름과 필요한 항목을 알려주면, 사용자의 문장에서 날짜와 제목을 찾아 함수 호출용 JSON으로 정리한다. JSON은 프로그램이 읽기 쉬운 일정한 형식의 데이터다.
에이전트는 사용자의 지시를 해석하고 도구나 함수를 골라 작업을 수행하는 소프트웨어를 뜻한다. Needle 3는 이런 자동화 에이전트를 서버가 아니라 사용자의 기기 안에서 구동하는 용도로 제시됐다. 텍스트를 숫자 배열로 바꾸는 임베딩도 지원해 기기 내 검색과 요청 분류에 쓸 수 있다고 회사는 설명했다.
무엇이 바뀌었나
회사는 Needle 3가 2개 층부터 20개 층까지 여러 크기의 하위 모델로 나뉘며, 하나의 8~29MB 파일로 제공된다고 밝혔다. 전체 모델은 1억2,100만 개 매개변수를 갖고 있으며, 3,600억 토큰의 자체 구조화 데이터로 학습됐다는 설명이다. 토큰은 모델이 글을 처리할 때 나누는 짧은 단위다.
출력은 함수 이름과 인자가 담긴 JSON, 문서에서 뽑은 구조화된 기록, 검색용 임베딩이다. Raspberry Pi 5에서 답을 생성하는 디코딩 속도가 초당 400~4,000토큰이고, 입력을 읽는 프리필 속도가 초당 1,000~10,000토큰이라는 회사 측 측정도 제시됐다. 모델은 Hugging Face, 코드는 GitHub, 설치 패키지는 PyPI, 직접 시험할 환경은 브라우저 샌드박스로 공개됐다.
왜 중요한가
처리를 기기 안에서 끝내면 자동화 요청을 매번 외부 서버로 보낼 필요가 없는 구성을 만들 수 있다. 네트워크가 불안정한 환경의 웨어러블, 로봇, 스마트홈 기기에도 적용 가능성이 있다. 여러 크기의 하위 모델 중 기기의 메모리와 속도에 맞는 것을 고를 수 있다는 점도 소형 하드웨어 개발자에게 유용하다.
실제로 어떤 의미인가
활용 예시: 스마트홈 앱 개발자가 “밤 11시에 거실 조명을 꺼 줘”라는 요청을 처리한다고 가정한다. 앱은 조명 제어 함수의 정의를 Needle 3에 함께 넣는다. 모델은 실행할 함수와 시간, 방, 동작을 JSON으로 채워 돌려주고 앱이 이를 실행한다. 기존의 서버 호출 방식 대신 이 과정을 지원 기기 안에서 처리하도록 설계할 수 있다.
사용·공개 범위
연구 예고가 아니라 모델과 관련 도구가 공개된 상태다. Hugging Face 모델 저장소, GitHub 코드 저장소, PyPI 패키지와 브라우저 샌드박스가 안내됐다. 모바일, 웨어러블, 로봇, 스마트홈, 자동차 및 마이크로컨트롤러가 배포 대상으로 제시됐지만, 구체적인 지원 기기 목록과 가격은 확인되지 않았다.
확인할 점
크기, 학습량과 Raspberry Pi 5 처리 속도는 Cactus Compute가 제시한 수치다. 작업 종류와 선택한 하위 모델에 따라 속도 범위가 크게 달라질 수 있다. 4개 층 모델을 특정 작업에 한 차례 추가 학습하면 DeepSeek V4 Flash와 맞먹는다는 주장도 회사 측 비교이며, 비교 작업의 세부 조건과 독립 검증 결과는 제공된 자료만으로 확인하기 어렵다. 최초 실행 시 Hugging Face에서 모델 파일을 받아 저장해야 한다는 설명도 있어 완전한 오프라인 사용은 다운로드 이후에 가능하다.
용어 풀이
함수 호출: 모델이 앱에서 실행할 기능을 고르고, 그 기능에 필요한 값을 정해진 형식으로 채우는 방식 토큰: AI 모델이 문장을 읽거나 생성할 때 사용하는 짧은 글자·단어 조각 단위 임베딩: 문장의 의미를 검색이나 분류에 쓸 수 있도록 숫자 배열로 바꾼 표현
Institute of Foundation Models, 여러 토큰을 함께 만드는 K2-Horizon-7B-Uno 어댑터 공개
발행 2026-09-18
Reddit · r/LocalLLaMA · 출처 이미지
Institute of Foundation Models는 기존 K2-Horizon-7B에 확산 방식의 생성 경로를 더하는 K2-Horizon-7B-Uno 어댑터를 Hugging Face에 공개했다. 전체 시스템 처리량이 초당 5,255토큰이라는 수치가 알려졌지만, 개별 요청 처리량은 초당 405토큰이므로 ‘초당 5,200토큰 생성’이라는 단순한 해석은 피해야 한다.
배경부터 이해하기
일반적인 자기회귀 언어 모델은 앞에서 만든 내용을 바탕으로 다음 토큰을 차례로 생성한다. 추론은 여기서 학습이 끝난 모델이 실제 입력을 받아 답을 계산하는 과정을 뜻한다. K2-Horizon-7B-Uno는 기존의 순차 생성 경로를 유지하면서, 여러 토큰을 함께 다듬어 생성하는 확산 경로를 추가한 구조로 설명됐다.
이번 저장소는 완전한 모델 파일이 아니라 LoRA 기반 어댑터만 제공한다. 어댑터는 기존 모델의 작동 방식을 비교적 작은 추가 파일로 조정하는 구성 요소다. 따라서 사용하려면 별도로 제공되는 K2-Horizon-7B 기본 모델 가중치도 필요하다.
무엇이 바뀌었나
공식 모델 카드에는 시스템 전체 처리량이 초당 5,255토큰, 요청 하나당 처리량이 초당 405토큰이라고 적혀 있다. 전자는 여러 요청을 포함한 시스템 전체가 같은 시간에 처리한 토큰 수이고, 후자는 개별 요청 기준이다. 커뮤니티 제목의 ‘5200 tps’는 전자 수치를 둥글게 표현한 것으로 보인다.
도구 사용, 소프트웨어 오류 수정, 긴 문맥 추론, 지식, 수학과 코드 생성 과제를 이용한 벤치마크 결과도 공개됐다. 벤치마크는 정해진 문제 모음으로 모델의 정확도나 작업 성공률을 재는 시험이다. 다만 제공 자료는 각 과제의 회사 측 점수를 보여줄 뿐, ‘속도를 높여도 품질 손실이 없다’는 표현을 독립적으로 입증하지는 않는다.
왜 중요한가
처리량이 실제 환경에서도 유지된다면 한 서버가 동시에 더 많은 요청을 처리하거나 긴 답변의 대기 시간을 줄이는 데 도움이 될 수 있다. 그러나 서비스 운영자는 전체 시스템 처리량과 한 사용자가 체감하는 속도를 구분해야 한다. 어댑터만 공개됐기 때문에 기존 기본 모델과 실행 환경을 준비할 수 있는 개발자에게 더 직접적으로 유용한 자료다.
실제로 어떤 의미인가
가정한 예시: 코드 검토 서비스가 동시에 여러 파일에 대한 질문을 받는다고 하자. 기존에는 순차 생성 경로만 사용하지만, 개발자는 기본 모델에 공개 어댑터를 결합해 확산 경로를 시험할 수 있다. 이때 초당 5,255토큰을 한 사람의 답변 속도로 간주하지 않고, 동시 요청 전체 처리량과 개별 요청의 초당 405토큰을 각각 측정해야 한다.
사용·공개 범위
어댑터는 Hugging Face에서 Apache-2.0 라이선스로 공개됐다. 기본 모델 가중치는 별도로 받아야 한다. 선택된 평가 스크립트만 현재 제공되며 전체 평가 도구는 추후 공개 예정이라고 적혀 있다. 모델 카드 기준으로 연결된 추론 서비스 제공자는 없어, 즉시 사용할 수 있는 호스팅 서비스와 가격은 확인되지 않았다.
확인할 점
속도와 품질 수치는 제작자가 게시한 모델 카드의 결과이며 독립 검증 자료가 아니다. 측정 하드웨어, 동시 요청 수와 입력·출력 길이에 따라 처리량은 달라질 수 있다. 평균 TPF 2.71이라는 수치도 제시됐지만 자료에 독자가 재현할 수 있는 충분한 정의가 없어 단독으로 성능을 해석하기 어렵다. 전체 평가 스크립트가 아직 제공되지 않아 모든 벤치마크를 같은 조건에서 확인하기도 제한된다.
용어 풀이
확산 방식: 답의 여러 부분을 한꺼번에 만든 뒤 반복해서 다듬는 생성 접근법 어댑터: 기본 모델 전체를 다시 배포하지 않고 기능이나 생성 방식을 바꾸는 작은 추가 파일 처리량: 시스템이 일정 시간 동안 처리한 토큰이나 요청의 총량
한 개발자, Radeon R9700 한 장에서 Qwen3.8 27B 처리 속도 개선 결과 공개
발행 2026-09-18
Reddit · r/LocalLLaMA · 출처 이미지
한 커뮤니티 사용자가 AMD Radeon R9700 그래픽카드 한 장에서 압축된 Qwen3.8 27B 모델을 최적화해, 단일 JSON 생성 중앙값 초당 153.1토큰과 16K 입력 처리 초당 3,619토큰을 기록했다고 공유했다. 특정 모델 파일과 실행 환경에서 나온 개인 벤치마크이므로 모든 R9700 사용자가 같은 성능을 얻는다는 뜻은 아니지만, 동일한 구성을 조정하려는 개발자에게 참고 자료가 된다.
배경부터 이해하기
Qwen3.8 27B는 약 270억 개 매개변수를 가진 언어 모델 계열이다. 이번 시험에는 Unsloth가 NVFP4 형식으로 양자화한 파일이 쓰였다. 양자화는 모델 숫자의 정밀도를 낮춰 저장 공간과 연산 부담을 줄이는 방법이다.
성능 측정은 입력을 먼저 읽는 프리필과 답을 생성하는 디코딩으로 나뉜다. 프리필은 긴 문서나 대화 기록을 처리하는 단계이고, 디코딩은 이후 토큰을 하나씩 출력하는 단계다. 따라서 두 속도는 서로 다른 대기 시간을 보여준다.
무엇이 바뀌었나
게시자는 최적화 뒤 전반적인 성능이 약 두 배가 됐다고 주장했다. 공개 표에서 단일 요청의 디코딩 중앙값은 JSON 생성 초당 153.1토큰, 일반 대화 67.1토큰, 코드 120.5토큰, 파일 편집 138.0토큰, 수학 140.0토큰이었다. 각 수치는 해당 작업에서 모델이 답을 생성한 속도이며 정답률을 뜻하지 않는다.
길이가 1만6,000토큰인 입력의 프리필은 초당 3,619토큰으로 기록됐다. 동시에 8개 요청을 처리했을 때의 합산 처리량은 초당 470토큰으로 제시됐다. 이 470은 요청 하나의 생성 속도가 아니라 여덟 요청 전체의 처리량이다. 사용된 모델은 vLLM을 지원하며, SGLang에서는 자료에 명시된 0.5.19 버전이 필요하다고 모델 카드에 적혀 있다.
왜 중요한가
로컬 AI의 체감 속도는 그래픽카드 이름만으로 결정되지 않는다. 모델의 압축 형식, 실행 프로그램과 동시 요청 설정이 함께 영향을 준다. 이번 결과는 R9700 한 장으로 270억 매개변수급 모델을 운영하려는 사람이 작업별 속도와 긴 입력 처리 속도를 따로 점검해야 한다는 점을 보여준다.
실제로 어떤 의미인가
가정한 예시: 개발자가 사내 코드 도우미를 R9700 한 장에서 운영한다고 하자. 최적화 전후에 같은 코드 질문과 1만6,000토큰 분량의 저장소 설명을 입력한다. 이후 코드 디코딩 속도, 프리필 속도와 답의 정확성을 각각 비교한다. 여러 직원이 함께 쓸 예정이라면 단일 요청 수치와 8개 동시 요청의 합산 처리량도 따로 확인한다.
사용·공개 범위
벤치마크에 사용된 Unsloth의 Qwen3.8-27B-NVFP4 모델은 Hugging Face에서 Apache-2.0 라이선스로 공개돼 있다. 게시자는 별도의 BetterBench GitHub 자료도 안내했다. 다만 최적화 설정의 전체 재현 절차, 필요한 운영체제와 드라이버 버전, 하드웨어 가격은 제공된 자료에서 확인되지 않았다.
확인할 점
공식 AMD 제품 발표가 아니라 개인이 공유한 특정 구성의 벤치마크다. ‘약 두 배 개선’의 정확한 이전 수치와 모든 시험 조건은 제공된 요약만으로 확인하기 어렵다. 생성 속도가 빨라도 답의 정확성이나 안정성이 같다는 뜻은 아니다. 또한 SGLang 호환성은 특정 버전으로 제한되며, 모델 카드에 따르면 출력층 일부가 4비트가 아닌 FP8 형식이어서 실행 환경 선택에 주의해야 한다.
용어 풀이
양자화: 모델이 사용하는 숫자의 정밀도를 낮춰 파일 크기와 연산량을 줄이는 기법 프리필: 모델이 답을 만들기 전에 긴 입력 내용을 먼저 읽고 계산하는 단계 디코딩: 입력 처리가 끝난 뒤 답변 토큰을 실제로 생성하는 단계
Reddit 이용자, vLLM이 대화 앞부분을 에이전트 작업 사이에 재사용하게 하는 방법 공유
발행 2026-09-17
Reddit · r/LocalLLaMA · 출처 이미지
한 커뮤니티 글이 인공지능 모델 실행 도구인 vLLM에서 대화 앞부분의 계산 결과를 다음 작업까지 재사용하려면 입력 형식을 매번 동일하게 유지해야 한다고 설명했다. 작성자 환경에서는 첫 답변 조각이 나오기까지의 평균 대기 시간이 26~28초에서 7.3초로 줄었지만, 특정 장비와 모델에서 나온 자체 측정치다.
배경부터 이해하기
vLLM은 개발자가 인공지능 모델을 서버에서 효율적으로 실행하도록 돕는 소프트웨어다. 에이전트는 모델이 대화를 이어가며 도구를 호출하고 여러 단계를 처리하는 프로그램을 뜻한다. 이런 프로그램은 다음 단계마다 이전 대화 전체를 다시 보내는 경우가 많다.
접두부 캐시는 긴 입력의 앞부분을 이미 계산했다면 그 결과를 보관했다가 재사용하는 기능이다. 그러나 시스템 지시문이나 도구 목록의 순서처럼 입력 앞부분이 조금이라도 달라지면 공통 구간이 일찍 끊겨, 모델이 뒤의 긴 내용을 다시 읽고 계산해야 할 수 있다.
무엇이 바뀌었나
공유된 운영 방법의 핵심은 캐시 용량만 늘리는 것이 아니라, 매 단계에서 만들어지는 입력을 글자와 토큰 단위로 안정적으로 유지하는 것이다. 특히 도구 정의의 항목 순서, 시스템 문구, 실시간 상태 정보가 불필요하게 바뀌지 않도록 직렬화 방식을 고정해야 한다.
작성자는 Qwen3.8-27B 모델, RTX 3090 두 대, vLLM 0.28.0 환경에서 기존 계산을 재사용한 입력 비율이 55%에서 95%로 높아졌다고 보고했다. 첫 토큰이 나오기 전 평균 대기 시간은 26~28초에서 7.3초로, 가장 긴 대기 시간은 514초에서 54초로 줄었다. 한 사례에서는 도구 연결 관문의 키 순서가 바뀌면서 1만2622개 토큰까지만 입력이 일치했고, 일부 단계가 다시 90~180초의 재계산을 겪었다.
왜 중요한가
여러 단계를 반복하는 에이전트는 이전 대화가 길수록 같은 내용을 다시 처리하는 시간이 커질 수 있다. 입력 앞부분을 동일하게 유지하면 이미 끝낸 계산을 재사용할 가능성이 높아져, 사용자가 답을 기다리는 시간과 서버의 중복 연산을 함께 줄일 수 있다. vLLM 팀도 별도 시험에서 세션당 중앙값 43단계, 입력 14만2000토큰인 작업을 다루며 접두부 캐시 재사용률이 96%를 넘었다고 보고해, 긴 에이전트 작업에서 이 방식의 중요성을 설명했다.
실제로 어떤 의미인가
가정한 활용 예시: 문서 검색 에이전트가 매 단계마다 같은 시스템 지시와 도구 목록, 이전 대화를 다시 보낸다고 하자. 이전에는 도구 목록의 키 순서가 매번 달라져 긴 입력을 다시 계산했다면, 변경 후에는 도구 정의를 항상 같은 순서로 만들어 공통 앞부분의 캐시를 재사용한다. 그러면 에이전트는 기존 문맥을 처음부터 다시 읽는 대신 새 질문과 새 도구 결과를 중심으로 처리할 수 있다.
사용·공개 범위
새 제품이나 별도 기능 출시 발표가 아니라, Reddit에 공유된 운영 안내다. 자체 측정에는 vLLM 0.28.0이 사용됐지만 다른 버전에서 같은 설정을 그대로 적용할 수 있는지, 별도 비용이 있는지, 모든 모델이 같은 효과를 내는지는 확인되지 않았다. vLLM 공식 글은 관련 캐시 유지 정책을 설명하지만 구체적인 일반 제공 범위는 출처에 제시되지 않았다.
확인할 점
속도와 재사용률 수치는 작성자의 로컬 장비에서 측정한 결과이며 vLLM의 공식 성능 시험이 아니다. 모델, 그래픽카드, 입력 길이와 구성에 따라 결과가 달라질 수 있다. vLLM 팀의 96% 이상 재사용률도 특정 AgentX 시험에서 측정한 회사 측 결과로, 모든 실제 작업을 보장하지 않는다. Reddit 원문은 자동 수집이 제한돼 제공된 요약과 보조 출처를 기준으로 정리했다.
용어 풀이
접두부 캐시: 긴 입력의 앞부분을 이미 계산한 결과를 저장했다가, 같은 앞부분이 다시 들어오면 재사용하는 장치다. 토큰: 인공지능 모델이 글을 처리할 때 나누는 작은 단위다. 단어나 글자 일부가 하나의 토큰이 될 수 있다. vLLM: 인공지능 언어 모델을 서버에서 실행하고 여러 요청을 처리하도록 돕는 공개 소프트웨어다.