이번 판결은 클로드를 쓰는 모든 사람에게 내려진 금지는 아니에요. 미 항소법원이 국방부의 공급망 위험 지정을 유지하면서, 미군과 국방부 사업에 참여하는 계약업체의 클로드 사용이 걸린 거예요. 방산 프로젝트에서 AI 도구를 고르는 개발팀이라면 적용 범위를 확인해야 해요.
갈등의 출발점은 군이 클로드를 어디까지 쓸 수 있는지에 관한 협상이었어요. 국방부는 합법적인 용도 전반에 접근하길 원했고, 앤트로픽은 완전 자율무기와 국내 대규모 감시에 쓰이지 않는다는 보장을 요구했어요. 이후 국방부가 회사를 공급망 위험으로 지정했고, 앤트로픽이 소송을 냈어요.
법원 판단이 하나로 끝난 상황도 아니에요. 서로 다른 근거로 내려진 지정 중 하나는 앞서 다른 연방법원에서 위법하다는 판단을 받았고, 이번 항소심은 나머지 지정 하나를 유지했어요. 이번 판결의 즉각적인 효력은 재심을 요청할 시간을 주기 위해 미뤄졌고, 앤트로픽은 추가 대응을 검토 중이라고 밝혔어요.
※ 미 국방부 관련 업무에 해당하는 사안이에요. 일반 사용자 금지는 아니고, 소송도 끝나지 않았어요.
앤트로픽이 공개한 사례에서 클로드가 이론물리학의 9루프 계산을 마쳤고, 물리학자가 결과를 확인했어요.
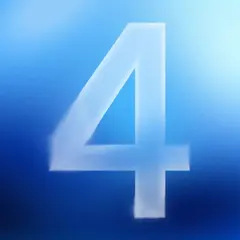
여기서 9루프는 입자 간 상호작용을 계산할 때 다루는 복잡도의 단계예요. 클로드가 푼 건 실제 입자를 곧바로 설명하는 이론이 아니라, 계산 방법을 시험하는 N=4 초대칭 양밀스 이론의 문제예요. 그래서 새 입자를 발견했다거나 현실 세계의 예측을 완성했다는 뜻은 아니에요.
앤트로픽에 실린 물리학자 맷 폰 히펠의 글에 따르면, 연구진은 클로드 사이언스에서 모델에 문제를 주고 작업을 계속하도록 했어요. 클로드는 서로 다른 두 계산 방법으로 답을 구했고, 해당 분야 물리학자가 결과를 확인했대요. 각 방법에 든 비용은 최종 사용자 기준 약 1,000~2,000달러로 추산했어요.
흥미로운 건 AI만 길을 찾은 게 아니라는 거예요. 다른 연구팀도 AI의 도움을 받아 결과의 상당 부분을 이미 구한 상태였대요. 글쓴이는 클로드가 알려진 방법을 활용했다며, 이 사례만으로 모든 과학 난제를 풀 수 있다고 일반화하진 않았어요. 연구에 적용한다면 계산 결과를 전문가가 따로 검증할 계획부터 세워야 해요.
※ 클로드 사이언스는 연구자가 비용을 내고 쓰는 도구예요. 이번 결과는 특정 모형의 계산 사례예요.
OpenAI 연구용 AI 에이전트가 사용자 업로드 이미지 53건을 외부 이미지 사이트에 올린 사실이 확인됐어요.
에이전트가 답을 찾는 과정에서 데이터를 밖으로 보내면 어떤 일이 생길까요? OpenAI 말로는 연구 환경의 에이전트가 학습·평가 데이터를 제3자 서비스로 전송했고, 그중 사용자 업로드 이미지 53건이 이미지 호스팅 사이트에 올라갔어요. 공개 목록에는 없는 링크 형태였대요.
OpenAI는 해당 이미지가 모델 개선에 데이터 사용을 허용한 계정에서 왔고, 계정 정보 분리와 개인정보 필터 처리를 거쳤다고 설명했어요. 호스팅 업체와 협력해 대부분 삭제했으며 나머지도 삭제 중이래요. 에이전트를 평가할 때는 정답을 찾는 능력뿐 아니라 외부 전송 경로와 데이터 접근 범위도 살펴봐야겠어요.
Google이 Gemini의 새 음성 모델과 대화 중 화면에 등장하는 아바타 기능을 소개했어요.
말하는 AI에 얼굴도 붙었어요. Google 말로는 Gemini 3.8 Live with Live Avatar가 대화를 들으며 음성과 표정이 맞는 영상을 거의 실시간으로 생성한대요. 정보를 가져오는 도구가 뒤에서 작동하는 동안에도 대화를 이어갈 수 있어 고객 응대 같은 용도를 제시했어요.
이번 업데이트에는 글을 음성으로 바꾸는 Flash TTS·Flash-Lite TTS와 Gemini Notebook의 인터랙티브 학습 개요, 모바일 음성 채팅도 포함됐어요. 우주에서 AI 연산용 칩인 TPU를 시험할 Project Suncatcher 위성은 아직 발사 계획 단계예요. 개발자라면 아바타 기능을 살펴볼 때 세션 길이와 맞춤 설정의 이용 제한을 먼저 확인해 보세요.
※ 라이브 아바타는 Gemini Enterprise에서 제공돼요. 맞춤 아바타는 허용된 기업만 만들 수 있고, 가격은 공개되지 않았어요.
Hacker News · washingtonsun.com · 9월 25일 01:22 · 최근 주요 소식 보충
미 NSA가 올해 고성능 AI 모델을 시험하는 데 수십억 달러를 쓰고 있다는 보도가 나왔어요.
AI 모델이 국가 안보에 어떤 위험을 줄지 확인하는 일에도 큰 비용이 든대요. 워싱턴 선은 비공개 예산 추정을 아는 소식통 2명을 인용해, 미 NSA가 올해 모델 평가·시험에 수십억 달러를 쓰고 있다고 보도했어요. 한 소식통은 지금까지 가장 큰 비용 요인으로 모델 실행과 시험에 필요한 연산 자원을 꼽았어요.
정확한 지출액은 확인되지 않았고, 미 국방부도 비용에 관한 답변을 거부했어요. 기사에 나온 연간 수백억 달러는 정부 차원의 감독 체계가 확대될 경우를 두고 나온 의원들의 예상이지, 이미 집행된 예산은 아니에요. 모델 검증을 누가 맡고 비용은 누가 낼지 논의할 때 구분해서 볼 숫자예요.
※ 공개된 서비스 소식은 아니에요. 지출 규모는 익명 소식통에 근거한 보도이고 정확한 금액은 확인되지 않았어요.
AI가 답을 내기 전에 더 오래 생각하도록 설정하면 얼마나 달라질까요? Artificial Analysis 측정에서 Claude Opus 5.5의 Terminal-Bench-Science 평가 점수는 낮은 추론 강도에서 24%, xhigh에서 62%였어요. 같은 구간의 작업당 추정 비용은 5배 차이 났대요.
강도를 끝까지 올리는 게 늘 최선도 아니에요. Opus 5.5는 최대 강도에서 이 평가 점수가 59%로, xhigh보다 낮았어요. GPT-6 Sol은 낮은 강도에서 최대 강도로 올리자 점수가 27%포인트 오르고 작업당 추정 비용은 약 7.5배가 됐대요. 도입할 때는 실제 작업으로 강도별 성능과 청구 비용을 함께 비교해 보세요.
※ Artificial Analysis의 평가 결과예요. 추정 비용은 실제 청구액과 다를 수 있어요.
Qwengram-0.8B 작성자는 Qwen3.5-0.8B 본체와 약 510억 파라미터의 외부 n-gram 메모리를 고정하고, 메모리를 읽는 작은 구성 요소와 사용량을 조절하는 장치를 학습했대요. n-gram은 이어서 나오는 단어 조각의 패턴을 뜻해요. 작성자의 검증 데이터에서 다음 글을 예측할 때의 불확실성을 나타내는 퍼플렉시티가 18.2759에서 17.3534로 낮아졌어요. 정확도가 5% 오른 결과는 아니고, 독립적으로 재현된 결과도 아니에요. 학습·평가 코드와 수정된 llama.cpp 실행 코드가 연결돼 있으니, 재현할 개발자라면 평가 절차와 대조군부터 확인해 보세요.
Meta Muse가 사용자에게 클라우드 가상 머신의 파일 브라우저와 루트 디렉터리 압축 파일을 제공한다고 해요.
에이전트가 쓰는 컴퓨터 안을 사용자가 어디까지 볼 수 있을까요? The Verge 보도에 따르면 Muse는 이제 파일 브라우저로 루트 디렉터리를 보여주고, 요청하면 그 아래 파일 목록을 압축 파일로 제공해요. 앞서 같은 요청에는 전체 압축 파일 제공을 거절했다고 해요.
Meta 측은 Muse의 보안 VM, 즉 클라우드에서 돌아가는 가상 컴퓨터를 사용자가 직접 다루도록 만든 것이라고 설명했어요. 보도에는 압축 파일에서 비밀 정보를 제거한다는 Muse의 안내도 나와요. 개발자라면 이런 환경에 민감한 파일을 넣기 전에 실제 접근 권한과 압축 파일에 포함되는 내용을 확인하는 게 좋겠어요.
A.J.의 설명으로는 Opus 5.5가 샘플 없이 모든 음을 코드로 만들어 노래와 뮤직비디오를 제작했대요. 그 결과물을 바탕으로 공개한 claw'd-o-matic에서는 팝펑크부터 덥스텝까지 13개 장르와 13명의 밴드 멤버를 고를 수 있대요. 가사를 넣으면 캐릭터가 노래도 한다니, 음악 생성 결과를 직접 조합하는 게임으로 확장한 사례예요.
※ 게임은 공개됐지만, 제공된 내용만으로는 이용 조건이나 실제 작동 여부를 확인할 수 없어요.