Mistral·Mozilla, 프랑스와 북미의 Firefox 스마트 브라우징 도우미에 Mistral 모델 적용
발행 2026-09-16
Mistral AI · 출처 이미지
Mistral과 Mozilla는 Firefox의 인공지능 브라우징 도우미인 Smart Window 베타를 Mistral 모델로 구동한다고 발표했다. 여러 탭의 내용을 바탕으로 검색과 요약을 돕되 대화를 기본적으로 Mozilla 서버에 저장하지 않는다고 밝혀, 브라우저 안의 문맥 활용과 개인정보 보호를 함께 추진한다.
배경부터 이해하기
Firefox Smart Window는 웹을 둘러보는 동안 인공지능의 도움을 받을 수 있는 시험판 기능이다. 사용자가 열어 둔 브라우저 탭을 문맥으로 활용해 복잡한 검색 결과를 정리하고, 전에 눌렀다가 닫은 중요한 내용을 다시 찾거나 필요한 정보의 출처를 확인하도록 돕는다.
여기서 인공지능 모델은 질문과 탭의 내용을 읽고 답변을 만드는 소프트웨어를 뜻한다. 이번 자료는 Smart Window가 이전에 어떤 모델로 작동했는지, 모든 탭을 자동으로 읽는지, 사용자가 탭별 접근 범위를 어떻게 지정하는지는 설명하지 않았다.
무엇이 바뀌었나
두 회사는 2026년 9월 16일 Smart Window 베타가 이제 Mistral 모델로 구동된다고 발표했다. 우선 프랑스와 북미 사용자를 지원하며, 영국과 독일은 2026년 안에 뒤따를 예정이라고 밝혔다. 후자는 확정된 출시가 아니라 회사가 제시한 계획이다.
Mistral은 지역 언어와 방언, 문화적 맥락에 맞게 모델을 조정한다고 설명했다. 개인정보 보호 측면에서는 Smart Window 대화가 기본 설정상 Mozilla 서버에 저장되지 않으며, Mistral 같은 협력사는 해당 데이터를 보관하지 않는 조건에 동의한다고 밝혔다. 두 회사는 사용자의 선택권과 서로 다른 인공지능 제공자의 경쟁도 협력 목표로 제시했다.
왜 중요한가
일반적인 인공지능 채팅에서는 사용자가 여러 웹페이지의 내용을 직접 복사해 질문에 붙여 넣어야 할 수 있다. 브라우저가 현재 탭의 맥락을 활용하면 자료 수집과 질문을 한 화면에서 이어갈 수 있어 조사 과정의 단계를 줄일 수 있다.
또한 브라우저 기록과 탭에는 민감한 정보가 섞일 수 있다. 따라서 대화를 기본적으로 Mozilla 서버에 저장하지 않고 모델 제공사도 데이터를 보관하지 않는다는 약속은 이용 여부를 결정할 때 중요한 조건이다. 다만 실제 보호 수준을 판단하려면 어떤 데이터가 전송되는지와 설정별 처리 방식에 대한 추가 설명이 필요하다.
실제로 어떤 의미인가
활용 예시: 여행을 준비하는 사용자가 항공편, 호텔, 현지 교통 안내를 각각 다른 탭에 열었다고 가정할 수 있다. 이전에는 각 페이지의 가격과 시간을 따로 메모해 비교했다면, Smart Window에서는 열린 탭을 바탕으로 일정별 선택지를 정리해 달라고 요청할 수 있다. 이는 기능을 설명하기 위한 가정이며, 해당 여행 작업이 실제로 시험됐다는 뜻은 아니다.
사용·공개 범위
Smart Window는 정식판이 아니라 베타로 발표됐다. 자료에 따르면 Mistral 지원 대상은 현재 프랑스와 북미이며, 영국과 독일은 2026년 안에 추가될 예정이다. 구체적인 국가별 시작일, 지원 언어 전체 목록, 이용 조건, 요금, 다른 지역의 출시 일정은 확인되지 않았다.
확인할 점
발표문은 Mistral과 Mozilla가 함께 작성한 회사 자료이므로 개인정보 보호와 지역 언어 품질에 관한 설명은 두 회사의 주장이다. 대화가 기본적으로 Mozilla 서버에 저장되지 않는다는 내용이 모든 처리가 사용자 기기 안에서 이뤄진다는 뜻은 아니다. 탭 데이터의 전송 범위, 보관하지 않는 데이터의 정확한 종류, 기능을 끄거나 접근 탭을 제한하는 방법은 제공된 자료만으로 확인할 수 없다. 베타 기능이므로 성능이나 제공 지역도 바뀔 수 있다.
용어 풀이
베타: 정식 출시 전에 실제 사용자에게 제공하며 기능과 안정성을 점검하는 시험 단계. 문맥: 인공지능이 답을 만들 때 함께 참고하는 현재 탭의 내용이나 앞선 대화 같은 주변 정보. 제로 데이터 보존: 서비스 제공사가 처리한 해당 데이터를 이후 저장해 두지 않기로 하는 운영 조건.
OpenAI, 미국 일부 광고주 대상으로 광고 클릭 뒤 상담하는 Sponsored Agents 시험
발행 2026-09-16
OpenAI 공식 로고
OpenAI는 ChatGPT 광고를 누른 사용자가 기업이 후원하는 대화형 도우미와 별도 상담을 시작할 수 있는 Sponsored Agents를 미국 일부 광고주와 시험한다. 광고주는 ChatGPT Work와 Ads Manager에서 광고를 만들고 분석할 수 있으며, HubSpot과 Shopify 연동도 추가돼 광고 제작부터 잠재 고객 관리까지 한 흐름으로 연결할 수 있다.
배경부터 이해하기
Sponsored Agents의 에이전트는 사용자의 요청을 받아 대화를 이어가거나 정해진 업무를 수행하는 인공지능 도우미를 뜻한다. 이 기능에서는 일반 ChatGPT 답변이 아니라 광고주가 후원하는 기업용 도우미가 상품이나 서비스에 관한 후속 대화를 맡는다.
Ads Manager는 광고 문구와 이미지, 대상, 예산, 일정, 성과를 관리하는 도구다. ChatGPT Work는 업무용 환경에서 자연어 지시로 관련 작업을 처리하는 제품으로 소개됐다. HubSpot은 고객과 영업 정보를 관리하는 서비스이고, Shopify는 온라인 상점을 운영하는 서비스다.
무엇이 바뀌었나
사용자가 ChatGPT 안의 광고를 클릭하면 명확히 광고임을 표시한 Sponsored Agent와 대화할 수 있다. 이 대화는 사용자의 원래 채팅 및 ChatGPT의 독립적인 답변과 분리된다. 현재는 미국의 일부 광고주를 대상으로 한 시험이며 전체 이용자나 광고주에게 정식 출시된 기능은 아니다.
광고주는 ChatGPT Work의 Ads Manager 플러그인에서 일상 언어로 캠페인을 만들고 수정하며 분석할 수 있다. Ads Manager의 인공지능은 방문 페이지와 광고 목표를 바탕으로 문구와 이미지를 제안하고, 기존 제목과 설명을 대화 맥락이나 사용자 선호 언어에 맞게 조정한다. 광고주가 제안을 검토하고 편집하는 구조다. HubSpot에서는 광고 제작·게시·성과 확인·후속 영업을 연결할 수 있고, 미국 Shopify 판매자는 앱으로 캠페인을 관리할 수 있다.
왜 중요한가
기존의 온라인 광고는 클릭한 뒤 별도의 상품 페이지나 문의 양식으로 이동하는 경우가 많다. Sponsored Agents는 클릭 직후 같은 서비스 안에서 질문을 이어가도록 해, 사용자가 원하는 조건을 설명하고 기업의 답을 받는 과정에서 화면 이동을 줄인다.
기업 입장에서는 광고 문구 작성, 캠페인 게시, 반응 측정, 잠재 고객 후속 연락이 서로 다른 도구에 흩어지는 문제를 줄일 수 있다. 특히 HubSpot 연동은 광고 참여 기록을 보고서와 업무 절차에 활용할 수 있게 한다. 다만 후원 대화가 판매 목적이라는 점을 사용자가 분명히 인식하는 것이 중요하다.
실제로 어떤 의미인가
가정한 예시: 한 사용자가 ChatGPT에서 업무용 의자 광고를 누른 뒤 Sponsored Agent에게 예산, 책상 높이, 배송 지역을 알려 주고 맞는 제품을 물을 수 있다. 이전에는 광고를 누르고 쇼핑몰을 검색한 다음 문의 양식을 작성해야 했다면, 이후에는 광고와 분리 표시된 대화에서 먼저 조건을 좁힐 수 있다. 이는 실제 시연 결과가 아니라 발표된 흐름을 설명하기 위한 예시다.
사용·공개 범위
Sponsored Agents는 미국의 일부 광고주와 시험 중이다. HubSpot 연동은 베타이며, 최고 관리자 권한으로 계정을 시험 프로그램에 등록하고 광고 게시 권한을 보유해야 한다. 미국 기반 Shopify 판매자는 Shopify App Store의 ChatGPT Ads 앱을 이용할 수 있다. 해외 제공은 ChatGPT Ads가 운영되는 시장에서 2026년 9월 23일부터 시작할 계획이다. 광고 상품의 공개 가격은 제시되지 않았지만, HubSpot 자료는 노출 1,000회당 고정 비용 방식이라고 설명한다.
확인할 점
Sponsored Agents는 제한된 시험이므로 일반 이용 가능 시점과 대상 확대 일정은 확인되지 않았다. OpenAI는 후원 대화를 일반 답변과 분리한다고 밝혔지만, 광고 도우미가 어떤 기업 데이터에 접근하는지와 답변 오류를 어떻게 처리하는지는 제공된 자료에 구체적으로 나오지 않는다. 인공지능이 만든 문구와 이미지는 제안이며 광고주가 검토하고 수정해야 한다. Shopify의 해외 제공도 ChatGPT Ads가 이미 지원되는 시장으로 한정된다.
용어 풀이
에이전트: 사용자와 대화하면서 질문에 답하거나 정해진 업무를 이어서 처리하는 인공지능 도우미. CRM: 고객 연락처, 상담, 영업 진행 상황과 후속 업무를 한곳에서 관리하는 시스템. 노출 1,000회당 비용: 광고가 사용자 화면에 1,000번 표시될 때마다 정해진 금액을 내는 가격 방식.
Emerald AI·Google·NVIDIA, 전력망 상황에 따라 데이터센터 전기 사용을 조절하는 연합 출범
발행 2026-09-16
NVIDIA Blog · 출처 이미지
Emerald AI, Google, NVIDIA는 인공지능 데이터센터가 전력망 상황에 맞춰 전기 사용량을 조절하도록 공통 기준을 만드는 AI Energy Management Alliance를 출범했다. 새로운 데이터센터 제품을 출시한 것이 아니라 전력 사용 감축 속도와 지속 시간 등을 측정해 전력망 연결 절차와 운영 규칙에 반영하려는 산업 연합이다.
배경부터 이해하기
인공지능 데이터센터는 많은 컴퓨터를 한곳에서 가동해 모델을 학습시키거나 사용자 요청에 대한 결과를 계산하는 시설이다. 이런 대규모 시설을 전력망에 연결하려면 발전량과 송전 설비, 비상 상황에서도 안정적으로 전기를 공급할 수 있는지를 검토해야 한다.
기존 전력망 연결 절차는 전기를 비교적 일정하게 쓰는 시설을 전제로 설계됐다고 발표문은 설명한다. 반면 데이터센터의 계산 작업은 일부 시간을 옮기거나 저장된 전력을 활용하는 방식으로 전력망에서 가져오는 전기의 양을 조절할 여지가 있다는 것이 연합의 출발점이다.
무엇이 바뀌었나
세 회사는 AI Energy Management Alliance, 즉 AEMA를 출범했다. 목표는 데이터센터가 전력망이 혼잡하거나 공급이 부족한 때 전기 사용을 줄이고, 여유가 있을 때 작업을 처리하도록 기술·운영 기준을 마련하는 것이다. 계산 작업의 시간 이동, 배터리 같은 저장 장치의 방전, 함께 설치한 발전 설비 활용, 비상 상황 대응이 가능한 수단으로 제시됐다.
AEMA는 특정 장비를 의무화하지 않고 결과를 측정하는 방식을 택한다. 시설이 얼마나 빨리 반응하는지, 조절 상태를 얼마나 오래 유지하는지, 예측 가능한지, 비상시에 어떻게 움직이는지를 기준으로 삼는다. 연결 전에 짧은 전력망 이상을 견디는 조건, 필요할 때 사용량을 줄이는 의무, 비상 대응 방식을 정하고 기술 요건과 운영 데이터 공유 형식을 표준화할 계획이다.
왜 중요한가
데이터센터가 항상 같은 양의 전기를 요구하면 전력회사는 최대 수요에 맞춰 송전망과 발전 설비를 늘려야 할 수 있다. 반대로 시설이 약속한 시간 안에 사용량을 낮출 수 있고 그 능력을 검증할 수 있다면, 전력망 운영자는 기존 설비를 더 효율적으로 활용하면서 연결 여부를 판단할 수 있다.
데이터센터 운영팀에는 단순히 컴퓨터 성능을 높이는 것뿐 아니라 어떤 계산을 미룰 수 있는지, 비상시에 얼마만큼 전력을 줄일 수 있는지, 이를 전력회사에 어떤 데이터로 증명할지가 새로운 운영 과제가 된다. 연합은 이런 약속이 신뢰할 만한 시설에 더 빠른 전력망 연결 경로를 마련하는 방안도 추진한다.
실제로 어떤 의미인가
가정한 예시: 지역 전력망에 수요가 급증했다는 신호가 오면 데이터센터가 즉시 처리할 필요가 없는 모델 학습 작업을 몇 시간 뒤로 옮기고, 배터리에 저장한 전력을 사용해 전력망에서 가져오는 양을 낮출 수 있다. 이전에는 시설이 일정한 전력을 계속 요구했다면, 이후에는 사전에 정한 감축량과 반응 시간을 지키고 그 기록을 전력망 운영자에게 제공하는 흐름이다. 이는 실제 현장 시험 결과가 아니라 연합이 제시한 운영 원칙을 설명한 예시다.
사용·공개 범위
AEMA는 2026년 9월 16일 발표된 산업 연합이며, 일반 사용자가 구입하거나 설치하는 제품이 아니다. 미국에서 적용할 수 있는 데이터센터 연결 및 운영 모델 개발에 초점을 둔다. 창립사 외에 인공지능 플랫폼, 데이터센터 사업자, 발전사, 전력회사와 지역 전력망 운영자의 참여를 추진한다. 회원 가입 조건, 비용, 첫 표준의 공개 시점, 실제 적용 시설은 제공된 자료에서 확인되지 않았다.
확인할 점
이 자료는 창립사인 NVIDIA의 공식 블로그 발표이며, 더 빠른 연결이나 비용 절감 효과는 연합이 기대하는 결과이지 입증된 성과가 아니다. 구체적인 감축량, 반응 시간, 적용 시설 수 같은 수치와 현장 시험 결과도 제시되지 않았다. 계산 작업을 미루면 서비스 일정에 영향을 줄 수 있고, 배터리나 별도 발전 설비에는 추가 비용이 들 수 있지만 발표문은 이런 상충 관계를 정량화하지 않았다. 전력망 연결 규칙은 지역 기관과 전력회사의 결정이 필요하므로 연합 원칙만으로 절차가 바로 바뀌는 것은 아니다.
용어 풀이
전력망: 발전소에서 만든 전기를 송전선과 변전소를 거쳐 이용 시설까지 보내는 전체 체계. 부하 조절: 전력망 상황에 맞춰 시설이 사용하는 전기의 양이나 사용 시간을 바꾸는 것. 계통 연결: 데이터센터 같은 대규모 전기 사용 시설이 전력망에 접속할 수 있도록 기술·비용·안전 조건을 심사하는 절차.
Microsoft는 AI를 안전하게 개발·운영하기 위한 회사의 기준과 사례를 담은 ‘2026 Responsible AI Transparency Report’를 공개했다. 보고서는 스스로 여러 단계를 수행하는 AI 에이전트의 확산, 사기와 딥페이크 악용, 언어·지역별 격차에 대응하려면 제품 출시 전후를 아우르는 관리 체계가 필요하다고 강조한다.
배경부터 이해하기
책임 있는 AI는 인공지능이 차별, 사기, 개인정보 침해 같은 피해를 일으키지 않도록 평가하고 통제하는 원칙과 절차를 뜻한다. 투명성 보고서는 기업이 어떤 내부 기준, 안전장치, 교육, 외부 협력을 운용하는지 설명하는 문서다.
이번 문서는 Microsoft의 세 번째 연례 보고서다. Microsoft Source Asia가 내용을 지역 관점에서 요약했으며, 별도의 공식 보고서 페이지에는 주요 항목과 사례가 공개돼 있다.
무엇이 바뀌었나
Microsoft는 지난 1년의 환경을 다섯 가지로 정리했다. AI 이용 확산과 지역·언어 격차, 더 지속적이고 자율적인 생성형 AI 및 에이전트 기능, 사기·딥페이크 악용 증가, 개인 지원과 건강 관련 안내를 위한 챗봇 이용 확대, 빠르게 변하는 규제가 포함된다. AI 에이전트는 사용자의 지시에 따라 여러 작업 단계를 이어서 처리하는 소프트웨어를 말한다.
회사는 책임 있는 AI 표준을 개정하고 에이전트 평가, 안전 제한, 설명 문서와 관리 절차를 강화했다고 밝혔다. 약 2만 명의 엔지니어·정책 담당자·고객에게 관련 교육도 제공했다. 동남아시아 언어의 안전성 연구, 여러 언어와 문화에서 위험을 점검하는 평가 기준 확대, 디지털 워터마크와 콘텐츠 출처 정보 적용 등의 활동도 소개했다.
왜 중요한가
기업이 AI를 도입할 때 일반적인 금지 규칙만 정해서는 지역 언어의 오해, 청소년과 챗봇의 민감한 상호작용, 조작 콘텐츠 같은 구체적 위험을 다루기 어렵다. 개발 전 평가부터 출시 후 감시와 사고 대응까지 담당 부서와 절차를 연결해야 한다는 운영상의 의미가 있다. 여러 언어를 지원하는 서비스라면 영어에서 통과한 안전성 평가가 다른 언어에서도 유효한지 별도로 확인할 필요가 있다.
실제로 어떤 의미인가
가정한 예시: 동남아시아 여러 국가에 상담 챗봇을 출시하려는 기업은 영어 답변만 검사하는 대신 현지 언어별 사기 유도, 건강 관련 오답, 과도하게 사람처럼 행동하는 표현을 시험한다. 문제가 발견되면 답변 제한과 신고 절차를 적용하고, 생성된 이미지에는 출처 확인 정보를 붙이는 식으로 출시 전후의 책임자를 정할 수 있다.
사용·공개 범위
보고서는 2026년 9월 16일 공개된 회사 발간물이며 공식 페이지에서 주요 내용과 사례를 확인할 수 있다. 특정 Microsoft 제품의 신규 출시나 유료 기능 발표는 아니다. 보고서 열람 대상, 제공 언어, 별도 가격에 관한 세부 정보는 supplied source에서 확인되지 않는다.
확인할 점
Microsoft Source Asia 글은 보고서 전체가 아니라 지역별 요약이다. 약 2만 명이라는 수치는 책임 있는 AI 교육을 받은 엔지니어·정책 담당자·고객의 합계이며, 교육 효과나 제품 안전성 향상 비율을 뜻하지 않는다. 소개된 평가 기준과 안전장치의 구체적인 방법론과 성과를 판단하려면 연결된 전체 보고서를 확인해야 한다. 위험 추세와 대응 효과에 관한 설명도 Microsoft의 자체 평가다.
용어 풀이
AI 에이전트: 한 번 답하는 데 그치지 않고 목표를 위해 여러 작업 단계를 이어서 수행하는 AI 소프트웨어 딥페이크: AI로 실제 인물의 얼굴이나 목소리처럼 보이게 만든 조작 콘텐츠 안전성 평가 기준: AI가 정해진 위험 상황에서 얼마나 안전하게 반응하는지 같은 조건으로 검사하는 방법
OpenAI는 2026년 4월부터 7월까지 업무 관련 ChatGPT 메시지 150만 건 이상을 분석해, 일부 근로자가 원래 직무 밖의 일을 AI로 시도한 뒤 반복 업무로 정착시키는 양상을 발표했다. 이 결과는 AI가 기존 업무의 속도만 높이는 데 그치지 않고, 직함을 바꾸지 않은 채 개인이 맡는 일의 범위를 넓힐 가능성을 보여준다.
배경부터 이해하기
OpenAI는 ‘직무 간 작업 이동’을 한 직업의 근로자가 통상 다른 직업과 연관된 업무에 AI를 사용하는 현상으로 정의한다. 예를 들어 소규모 사업자가 홍보 문구를 쓰거나 기본적인 재무 설명을 준비하는 경우다.
앞선 2026년 7월 연구는 미국 ChatGPT 사용자의 업무 메시지 80만 건 이상을 조사했다. 당시 전체 업무 관련 메시지의 16.8%, 직업별로 분류할 수 있는 업무 메시지의 43.5%가 다른 직업과 연관된 작업을 다뤘다고 OpenAI는 밝혔다. 새 연구는 이런 사용이 한 번의 실험으로 끝나는지, 다음 달에도 이어지는지를 살폈다.
무엇이 바뀌었나
새 분석은 2026년 4월부터 7월까지 업무 관련 ChatGPT 메시지 150만 건 이상을 대상으로 했다. 이 기간에 꾸준히 관찰된 약 6,200명의 직업별 AI 활동 가운데, 과거에도 사용했던 직무 밖 작업의 비중은 4월 13.1%에서 7월 25.9%로 높아졌다. 이는 전체 근로자의 25.9%가 직무를 바꿨다는 뜻이 아니라, 해당 표본의 직업별 AI 활동에서 재사용된 직무 밖 작업이 차지한 비율이다.
별도의 한 달 단위 비교에서는 이전 달에 직무 밖 작업을 했던 사람이 다음 달 같은 종류의 작업으로 돌아온 비율이 23.6%였다. 이전 사용이 관찰되지 않은 비교 집단은 8.4%였다. 작업별 다음 달 재사용률은 고객과 상품·서비스를 논의하는 업무 54%, 광고·홍보 글쓰기 44%, 마케팅 자료 제작 37%, 재무 정보 설명 약 15%였다. 모든 직무 밖 작업의 평균 재사용률은 18.5%였다.
왜 중요한가
반복 사용이 늘면 조직은 AI 교육을 단순한 문서 요약법에 한정하기보다, 직원이 새로 맡게 된 업무의 검토 기준과 책임 범위까지 정해야 한다. 특히 고객 커뮤니케이션이나 홍보처럼 재사용률이 높은 작업은 정형화된 절차가 되기 쉽다. 반면 재무 설명처럼 오류의 결과가 큰 업무는 전문가 검토를 유지해야 한다. 직무명이 그대로여도 실제 업무 구성이 달라질 수 있으므로 인력 배치와 교육 수요를 실제 작업 단위로 살펴볼 이유가 생긴다.
실제로 어떤 의미인가
가정한 예시: 이전에는 가게 주인이 신상품 정보를 홍보 담당자에게 전달하고 문구를 기다렸다. AI 사용 이후에는 주인이 ChatGPT로 초안을 반복 작성하고 담당자는 사실관계와 표현만 검토한다. 작성 업무가 매달 되풀이되면 주인의 역할에 기본 홍보 작업이 추가되지만, 최종 승인 책임까지 자동으로 바뀌는 것은 아니다.
사용·공개 범위
2026년 9월 16일 공개된 OpenAI Economic Research의 관찰 연구다. 새로운 ChatGPT 기능이나 별도 상품 출시가 아니므로 이용 요금과 출시 지역은 적용되지 않는다. 원문 게시물에서 연구 설명을 확인할 수 있으나, 세부 데이터의 외부 제공 여부는 확인되지 않았다.
확인할 점
분석은 관찰된 ChatGPT 이용자와 메시지를 대상으로 하므로 전체 노동시장이나 모든 직업을 대표하지 않는다. 메시지에서 같은 종류의 작업이 다시 나타난 사실은 실제 업무 성과, 고용 변화 또는 직무 전환을 증명하지 않는다. 23.6%와 8.4%의 차이도 이전 사용과 재사용의 연관성을 보여줄 뿐, AI가 반복 업무를 직접 유발했다는 인과관계를 확정하지 않는다. 수치 해석과 직무 확대라는 결론은 OpenAI의 자체 연구에 기반한다.
용어 풀이
직무 간 작업 이동: 자신의 직업보다 다른 직업과 주로 연관된 일을 AI로 수행하는 현상 재사용률: 이전 달에 했던 종류의 작업을 다음 달에도 다시 한 사람의 비율 관찰 연구: 연구자가 조건을 배정하지 않고 실제로 나타난 이용 행동을 분석하는 연구
OpenAI, ChatGPT Enterprise 관리자에게 ChatGPT·Codex 통합 사용량 분석 제공
발행 2026-09-16
OpenAI 공식 로고
OpenAI는 ChatGPT Enterprise 관리자가 ChatGPT와 코딩 작업용 Codex의 크레딧 사용량을 한 화면에서 보고, 사용자·제품·모델별 지출과 이용 추세를 파악하는 기능을 제공하고 있다. 회사는 이 데이터를 단순한 비용 감시가 아니라 완료한 작업, 절약한 시간, 줄어든 처리 기간 같은 업무 결과와 연결해 해석해야 한다고 설명했다.
배경부터 이해하기
기업은 직원들이 AI를 얼마나 자주 쓰는지 확인해도 그 사용이 실제 성과로 이어졌는지 판단하기 어렵다. 사용량이나 청구액이 늘어난 원인은 낭비일 수도 있지만, 새로운 업무를 시험하거나 핵심 절차가 AI에 의존하기 시작했기 때문일 수도 있다.
ChatGPT Enterprise는 조직 관리 기능을 포함한 기업용 ChatGPT 상품이다. Codex는 코딩 작업에 사용하는 도구다. OpenAI가 말하는 크레딧은 특정 AI 작업에 소비되는 사용 단위다. 회사는 여러 단계를 거치는 작업의 경우 소비량만 비교하지 말고, 원하는 결과를 얻기까지 든 전체 비용을 봐야 한다고 권고했다.
무엇이 바뀌었나
OpenAI가 2026년 6월 공개한 Enterprise 기능은 Global Admin Console에서 ChatGPT와 Codex의 크레딧 사용량을 함께 보여준다. 관리자는 사용자·제품·AI 모델별 지출, 시간에 따른 변화, 사용량이 많은 사람과 새롭게 나타나는 이용 패턴을 확인할 수 있다. 같은 데이터를 통합 Cost API로도 받을 수 있다. API는 다른 프로그램이 정해진 방식으로 데이터나 기능을 요청하도록 만든 연결 규칙이다.
관리자는 전체 작업 공간의 기본 사용 한도를 설정하고, 특정 그룹에 다른 한도를 적용하거나 필요한 개인에게 별도 한도를 줄 수 있다. OpenAI의 후속 운영 지침은 비용 대비 완료된 작업, 절약한 시간, 단축된 처리 기간, 보호한 매출, 피한 위험, 새로 확보한 업무 여력을 함께 측정하라고 제안한다. 이는 새로운 자동 성과 측정 기능의 발표라기보다, 사용량 데이터를 업무 결과와 연결하는 관리 방법에 관한 회사의 권고다.
왜 중요한가
부서별 사용량만 보면 많이 쓰는 팀을 성과가 높은 팀으로 잘못 판단할 수 있다. 사용량과 실제 결과를 함께 비교하면 교육이 필요한 팀, 시험 운영을 확대할 업무, 비용만 커지는 절차를 구분하기 쉬워진다. 그룹별 한도는 검증되지 않은 사용의 급증을 막으면서 성과가 확인된 팀에는 더 많은 용량을 배정하는 데 쓸 수 있다. 다만 관리 화면 자체가 매출 증가나 시간 절약을 자동으로 증명해 주는 것은 아니다.
실제로 어떤 의미인가
활용 예시: 고객지원팀의 크레딧 사용이 한 달 사이 크게 늘었다면 관리자는 먼저 사용자와 제품별 증가 원인을 확인한다. 이후 같은 기간의 문의 처리 시간과 재문의율을 내부 자료로 비교한다. 처리 시간이 줄고 품질이 유지됐다면 팀 한도를 높일 수 있다. 변화가 없다면 교육 방식을 점검하거나 해당 작업의 사용 한도를 유지할 수 있다.
사용·공개 범위
통합 사용량 분석과 지출 제한 기능은 2026년 6월 18일 기준 ChatGPT Enterprise 관리자에게 제공된 기능이다. 해당 작업 공간의 일반 사용자는 설정에서 자신의 크레딧 사용량을 볼 수 있다. 다른 ChatGPT 요금제 제공 여부와 별도 가격은 supplied source에서 확인되지 않는다. 2026년 9월의 관련 글은 운영 지침이며 별도의 신제품 출시 발표가 아니다.
확인할 점
사용량 분석은 대화 내용 감시 기능과 구분된다. supplied source에 따르면 관리자가 이 화면으로 개별 대화 기록을 열람하는 것은 아니며, 사용자는 직접 공유하지 않는 한 자신의 비공개 대화 기록을 유지한다. 크레딧 소비량은 업무 가치 자체가 아니다. 완료 작업, 시간 절약, 품질, 위험 감소 같은 조직 내부 자료와 결합해야 한다. ‘비용 대비 유용한 업무’를 측정하라는 방법론은 OpenAI의 권고이며 객관적인 성과를 보장하지 않는다.
용어 풀이
크레딧: 기업용 AI 기능을 사용할 때 소비량과 비용을 계산하는 사용 단위 API: 서로 다른 프로그램이 정해진 형식으로 데이터나 기능을 주고받는 연결 규칙 작업 공간: 한 기업이나 팀이 사용자, 권한, 사용 한도를 함께 관리하는 계정 영역
OpenAI와 AARP, 미국 10개 도시에서 노년층 1,000명에게 무료 ChatGPT 실습 제공
발행 2026-09-17
OpenAI 공식 로고
OpenAI는 AARP 산하 OATS와 함께 미국 10개 도시에서 노년층 1,000명을 대상으로 무료 대면 ChatGPT 실습을 시작한다고 밝혔다. 여행 계획이나 청구서 이해 같은 일상 활용뿐 아니라 사기 메시지의 징후를 살피는 방법도 가르쳐, 고령 이용자가 AI를 더 안전하게 쓰도록 돕는 교육 사업이다.
배경부터 이해하기
ChatGPT는 질문이나 요청을 글로 입력하면 답변을 생성하는 AI 서비스다. 사용자는 여행 일정을 정리하거나 어려운 문서를 쉽게 풀어 달라고 요청할 수 있지만, 답변이 항상 정확한 것은 아니므로 판단을 대신 맡겨서는 안 된다.
이번 행사는 OpenAI Academy와 AARP 산하의 Older Adults Technology Services(OATS)가 운영하는 ‘Older Adults AI Skills Jam’이다. 양측은 2025년부터 노년층의 AI 활용과 온라인 안전 교육을 위한 다년 협력을 진행해 왔다. 기존 협력에는 사기 식별 영상, 개인정보 보호 과정, 안내서 개정과 지역 교육 확대 계획이 포함됐다.
무엇이 바뀌었나
양측은 Denver, Miami, San Antonio, Montgomery County, Queens를 포함한 미국 10개 지역에서 총 1,000명에게 무료 오프라인 실습을 제공한다고 발표했다. 교육 주제는 여행 계획, 이해하기 어려운 편지나 청구서 정리, 취미 탐색, 가족과의 소통 등이다.
온라인 사기 예방도 별도 주제로 다룬다. 참가자는 지나치게 긴급한 표현, 비밀을 요구하는 말, 의심스러운 링크 같은 경고 신호를 확인하는 법을 배운다. OpenAI는 미국에서 55세 이상과 관련된 메시지가 전체의 6%에서 약 10%로 늘었다고 설명했다. 이는 1년 동안 약 4%포인트 증가했다는 뜻이며, 노년층 개인의 이용량이 4% 늘었다는 의미는 아니다.
왜 중요한가
AI 사용법을 온라인 설명서가 아니라 직접 따라 하는 대면 교육으로 전달하면, 처음 접하는 사람도 질문을 입력하고 답변을 검토하는 과정을 배울 수 있다. 특히 사기 의심 메시지를 ChatGPT에 보여 주는 방법과 함께 최종 판단은 본인이 해야 한다는 원칙을 가르치면, AI를 보조 수단으로 활용하면서도 잘못된 답변을 그대로 믿는 위험을 줄일 수 있다. 공공기관이나 소비자 대상 서비스를 운영하는 조직에도 특정 이용자층의 실제 상황에 맞춘 교육 사례가 된다.
실제로 어떤 의미인가
활용 예시: 한 참가자가 ‘오늘 안에 송금하지 않으면 계정이 정지된다’는 문자메시지를 받았다고 가정하자. 교육 전에는 링크를 바로 누르거나 가족에게 단순히 전달할 수 있다. 교육 후에는 개인정보를 지운 문구를 ChatGPT에 입력해 긴급성 강조와 수상한 링크 같은 징후를 정리하고, 문자 속 번호가 아니라 해당 기관의 공식 연락처로 직접 확인할 수 있다. ChatGPT의 판단만으로 송금 여부를 결정하지 않는 것이 핵심이다.
사용·공개 범위
미국 10개 도시의 노년층 총 1,000명을 대상으로 하는 무료 대면 교육이다. OpenAI와 OATS가 OpenAI Academy를 통해 진행한다고 밝혔지만, 도시별 정확한 개최 날짜와 신청 절차, 참가 연령 기준은 제공된 자료에서 확인되지 않는다. 일반 ChatGPT의 새 기능이나 유료 상품 출시는 아니다.
확인할 점
교육이 실제로 사기 피해를 얼마나 줄이는지 보여 주는 결과 자료는 제시되지 않았다. ChatGPT는 의심스러운 메시지를 검토하는 ‘두 번째 시선’으로 쓰일 수 있지만, 사기를 확정적으로 판별하거나 기본 보안 수칙을 대신하지 못한다. 55세 이상 관련 메시지 비중 역시 OpenAI가 제시한 자체 서비스 수치이며, 전체 노년층의 AI 사용률을 뜻하지 않는다.
용어 풀이
ChatGPT: 사용자가 글로 질문하거나 일을 요청하면 문장 형태로 답을 만드는 OpenAI의 AI 서비스다. OATS: AARP 산하에서 노년층의 기술 교육을 지원하는 조직이다. %포인트: 두 비율의 차이를 나타내는 단위다. 6%에서 10%로 늘면 4%포인트 증가다.
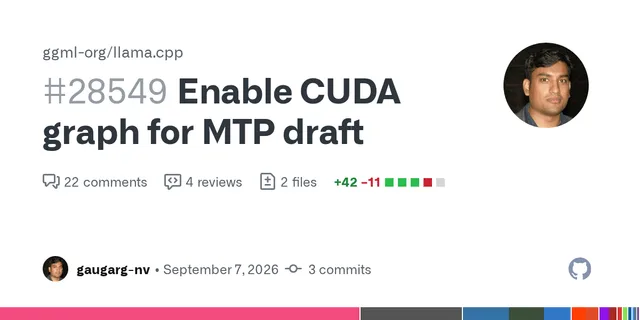
llama.cpp 기여자, MTP 초안 생성에서 CUDA 작업 반복 준비를 줄이는 코드 변경 제안
발행 2026-09-17
Reddit r/LocalLLaMA · 출처 이미지
llama.cpp의 공개 코드 저장소에 MTP 초안 생성 과정에서 CUDA 그래프를 반복해서 준비하는 일을 줄이는 변경안이 제출됐다. 기여자가 RTX 5090에서 측정한 결과로는 문장 생성 속도가 초당 279.04토큰에서 291.33토큰으로 높아졌지만, 아직 병합되지 않은 제안이며 독립 검증도 없다.
배경부터 이해하기
llama.cpp는 개인용 컴퓨터에서 여러 언어 모델을 실행할 수 있게 하는 오픈소스 프로그램이다. 여기서 추론은 이미 학습된 모델이 입력을 읽고 답을 생성하는 실행 과정을 뜻한다. 토큰은 모델이 글을 처리하는 작은 단위로, 단어나 단어 조각에 가깝다.
MTP는 여러 미래 토큰의 초안을 먼저 만들고 일부를 채택해 생성을 빠르게 하려는 방식이다. CUDA 그래프는 엔비디아 GPU가 반복할 계산 순서를 미리 기록해 준비 비용을 줄이는 기능이다. 제안 작성자에 따르면 기존 MTP 경로에서는 출력이 있는 초안 작업과 출력이 없는 보충 작업이 같은 캐시 식별 정보를 공유해, 기록된 CUDA 그래프가 서로 교체되며 다시 준비되는 일이 생겼다.
무엇이 바뀌었나
GitHub의 llama.cpp PR #28549는 출력이 없는 작업을 위한 별도 결과 저장 공간을 추가한다. 두 종류의 계산이 서로 다른 고정 캐시 키를 사용하게 해, 디코딩 중 CUDA 그래프가 반복해서 다시 기록되는 현상을 막는 것이 목적이다. 변경안은 3개 커밋으로 구성됐으며 현재 공개 PR 상태다.
작성자는 Windows와 RTX 5090, Qwen3.6-35B-A3B의 특정 압축 파일, MTP3 설정에서 자체 측정을 진행했다. 입력 처리 속도는 초당 87.02토큰에서 91.10토큰으로, 답변 생성 속도는 초당 279.04토큰에서 291.33토큰으로 높아졌다고 주장했다. 전체 지연 시간은 3.076초에서 3.013초로 줄었고, 초안 토큰이 실제 답변에 채택된 비율은 0.7061, 즉 약 70.61%로 같았다.
왜 중요한가
대화형 로컬 AI에서는 답변을 시작하고 이어 쓰는 동안의 짧은 지연도 사용감에 영향을 준다. 같은 GPU 계산을 반복해서 준비하는 일을 줄이면 모델 자체를 바꾸지 않고도 응답 흐름이 조금 더 빨라질 수 있다. 다만 제시된 생성 속도 향상은 약 4.4%이며 특정 고급 GPU와 모델 설정에서 나온 결과다. 대량 요청 처리보다 한 번에 대화하는 환경에서 더 유용할 수 있다는 의견이 커뮤니티에 나왔지만, 이는 측정으로 확인된 결론이 아니다.
실제로 어떤 의미인가
가정한 예시: 개발자가 자신의 PC에서 코딩 도우미 모델을 실행하며 짧은 질문을 연달아 보낸다고 하자. 변경 전에는 MTP의 서로 다른 작업 모양이 번갈아 실행될 때 CUDA 그래프를 다시 준비하는 비용이 반복될 수 있다. 제안한 코드가 의도대로 작동하면 각 작업이 이미 기록된 그래프를 재사용해 답변 생성 지연을 조금 줄일 수 있다. 실제 차이는 GPU, 모델, 압축 방식과 질문 길이에 따라 달라진다.
사용·공개 범위
정식 출시 기능이 아니라 llama.cpp의 GitHub 저장소에 제출된 공개 코드 변경 제안이다. 제공된 자료 기준으로 PR은 열려 있으며 master 코드에 병합되지 않았다. 따라서 일반 배포판에서 사용할 수 있는 시점은 확정되지 않았고, 병합 여부나 출시 버전도 확인되지 않는다.
확인할 점
성능 수치는 PR 작성자가 한 가지 하드웨어와 모델 조합에서 측정한 결과다. 다른 GPU나 운영체제, 모델, 동시 요청 환경에서도 같은 향상이 나오는지는 확인되지 않았다. Reddit 글은 이 PR을 소개한 짧은 커뮤니티 게시물일 뿐 공식 출시 공지가 아니다. 초당 토큰 수가 높아져도 답변의 정확성이나 품질이 개선됐다는 뜻은 아니다.
용어 풀이
추론: 학습을 마친 AI 모델이 입력을 처리해 실제 답변을 만드는 실행 과정이다. 토큰: AI가 글을 읽고 생성할 때 사용하는 단어나 단어 조각 단위다. PR: 오픈소스 저장소에 코드 변경을 검토하고 합쳐 달라고 요청하는 제안이다.
Reddit 사용자, 12GB 그래픽카드에서 Qwen3.8-Flash-Next를 초당 15토큰으로 실행했다고 공개
발행 2026-09-17
AI 뉴스 기본 이미지 · AI 생성 일러스트
한 Reddit 사용자가 12GB 메모리를 갖춘 RTX 5070 SFF에서 압축된 Qwen3.8-Flash-Next 모델을 실행해 답변을 초당 약 15토큰 생성했다고 보고했다. 대형 모델을 비교적 작은 그래픽카드에서 구동할 가능성을 보여 주는 개인 사례지만, 제조사 시험이나 독립적으로 재현된 결과는 아니다.
배경부터 이해하기
로컬 언어 모델은 외부 AI 서비스에 요청을 보내는 대신 개인 PC에서 직접 실행하는 모델이다. 실행 과정인 추론에는 그래픽카드 메모리인 VRAM과 일반 시스템 메모리가 필요하며, 모델이 크면 모든 데이터를 VRAM에 담기 어렵다. 일부 데이터를 일반 메모리나 저장장치 쪽에서 처리하면 작은 그래픽카드에서도 실행할 수 있지만 속도는 구성에 따라 크게 달라진다.
이 사례는 Qwen3.8-Flash-Next의 GGUF 파일을 약 3bpw 수준으로 압축해 사용했다. bpw는 모델의 각 가중치, 즉 학습된 수치를 평균 몇 비트로 저장하는지 나타낸다. 숫자를 낮추면 필요한 저장 공간과 메모리를 줄일 수 있지만, 모델의 출력 품질이 달라질 수 있다.
무엇이 바뀌었나
게시자는 12GB VRAM을 탑재한 RTX 5070 SFF에서 Qwen3.8-Flash-Next-GSQ-RCO-GGUF의 IQ3_XXS 설정을 실행했다고 밝혔다. 답변 생성 속도는 초당 약 15토큰이었고, 입력 문장을 읽고 준비하는 속도는 초당 약 100~120토큰이었다. 토큰은 AI가 문장을 처리하는 단어나 단어 조각 단위다.
작성자에 따르면 전체 GGUF 파일은 약 76GB이며, 이 가운데 약 47GB를 VRAM과 시스템 RAM에 나눠 올리고 나머지는 SSD를 활용하는 방식이었다. 작성자는 자신의 시험에서 출력 품질이 좋았다고 평가했지만, 이를 측정한 객관적인 정확도 시험이나 다른 모델과의 통제된 비교 결과는 제시하지 않았다.
왜 중요한가
대형 모델을 실행할 때 그래픽카드 메모리가 부족하면 더 비싼 장비가 필요하다고 판단하기 쉽다. 이 사례는 강한 압축과 메모리 분산, SSD 활용을 조합하면 12GB급 그래픽카드에서도 모델을 실제로 실행할 여지가 있음을 보여 준다. 다만 ‘실행 가능’과 ‘모든 작업에서 쾌적함’은 다르다. 초당 15토큰이라는 수치는 해당 설정에서 답변을 구성하는 토큰이 1초에 약 15개 나왔다는 뜻이며, 다른 12GB 카드에서도 같은 속도가 보장된다는 뜻은 아니다.
실제로 어떤 의미인가
가정한 예시: 사용자가 긴 기술 문서를 외부 서버에 올리지 않고 자신의 PC에서 요약하려 한다고 하자. 변경 전에는 모델 전체가 12GB VRAM에 들어가지 않아 실행을 포기할 수 있다. 이 게시물의 구성처럼 압축 모델을 쓰고 데이터를 VRAM, 일반 RAM과 SSD에 나누면 로컬 실행을 시도할 수 있다. 다만 문서를 처음 읽는 속도와 답변 생성 속도는 PC의 메모리 용량, SSD 성능, 문서 길이에 따라 게시자의 결과보다 느려질 수 있다.
사용·공개 범위
공식 제품 출시나 제조사 제공 기능이 아니라 Reddit 사용자가 공개한 개인 실행 사례다. 게시물에는 압축 모델 배포 페이지와 사용한 실행 도구의 문서가 연결됐다고 전해졌지만, 설치 절차와 필수 시스템 RAM 용량, 소프트웨어 버전은 제공된 자료만으로 확정할 수 없다. 가격 정보도 확인되지 않는다.
확인할 점
한 사용자가 한 대의 PC에서 얻은 자체 측정값이다. 동일한 모델 이름이라도 압축 수준, 메모리 분산 방식, 실행 프로그램, 입력 길이에 따라 속도와 품질이 달라진다. 초당 15토큰은 답변 생성 속도이며 입력 처리 속도인 초당 100~120토큰과 같은 측정 항목이 아니다. 장시간 안정성, 전력 사용량, 정확성, 다른 12GB 그래픽카드에서의 재현 여부는 확인되지 않았다.
용어 풀이
VRAM: 그래픽카드가 모델 데이터와 계산 결과를 보관하는 전용 메모리다. 토큰: 언어 모델이 문장을 읽고 만들 때 사용하는 단어나 단어 조각 단위다. GGUF: 언어 모델을 개인 PC에서 실행하기 쉽도록 저장하는 데 널리 쓰이는 파일 형식이다.
레딧 사용자가 V620 그래픽카드 4대로 Qwen3.8 모델의 코딩 답변을 초당 68.3~72.5토큰 생성
발행 2026-09-17
AI 뉴스 기본 이미지 · AI 생성 일러스트
한 레딧 사용자가 V620 그래픽카드 4대에서 Qwen3.8-Flash-Next를 실행한 성능 측정 결과를 공개했다. 코딩 작업에서는 입력 길이에 따라 답변을 초당 68.3~72.5토큰 생성했지만, 특정 장비와 소프트웨어를 사용한 개인 측정이므로 다른 환경에서도 같은 속도가 나온다고 단정할 수 없다.
배경부터 이해하기
이 사례는 외부 업체의 온라인 서비스가 아니라 사용자가 직접 장비를 관리하며 AI 모델의 추론, 즉 입력을 읽고 답변을 계산하는 작업을 실행한 것이다. 코딩용 AI는 코드 작성이나 분석을 돕지만, 실제 응답 속도는 그래픽카드 수, 입력 길이, 실행 프로그램과 모델 압축 방식에 따라 달라진다.
성능 측정은 입력을 먼저 읽는 속도와 답변을 생성하는 속도를 구분한다. 토큰은 모델이 글을 처리하는 작은 단위이며, 초당 토큰 수가 높을수록 같은 조건에서 입력 분석이나 답변 표시가 더 빠르다는 뜻이다.
무엇이 바뀌었나
게시자가 공개한 표에 따르면 입력 처리 속도는 작업과 입력 길이에 따라 초당 약 1,296~1,393토큰이었다. 코딩 작업의 답변 생성 속도는 입력 범위가 32K일 때 초당 70.0토큰, 64K에서 72.5토큰, 128K에서 68.3토큰이었다. K는 여기서 약 1,000토큰 단위의 입력 범위를 뜻한다.
구성에는 RDNA2 기반 V620 그래픽카드 4대, vLLM 실행 소프트웨어, Intel/Qwen3.8-Flash-Next-W4A16-AutoRound 모델이 사용됐다. 이 모델은 계산량과 메모리 사용을 줄이도록 수치를 압축한 양자화 버전이다. 게시자는 품질 손실 수준도 추정했지만 공식 검증값은 아니다.
왜 중요한가
개인이나 개발팀이 자체 장비에서 코딩 보조 모델을 운영하려 할 때, 그래픽카드 4대로 어느 정도의 입력 처리량과 답변 생성 속도를 기대할 수 있는지 보여주는 참고점이다. 다만 이는 모델 자체의 보편적인 성능이 아니라 특정 하드웨어·실행 프로그램·압축 설정을 합친 결과이므로, 장비 도입 판단 전에는 같은 작업으로 직접 재측정해야 한다.
실제로 어떤 의미인가
활용 예시: 개발팀이 긴 코드 저장소를 자체 서버에서 분석하려 한다고 가정할 수 있다. 도입 전에는 이 게시물의 32K·64K·128K 결과를 후보 구성의 참고치로 삼고, 도입 후에는 실제 저장소와 같은 입력 길이로 입력 처리 속도와 답변 생성 속도를 각각 측정해 업무에 충분한지 확인한다. 이 예시는 게시자가 실제로 시험한 업무 사례가 아니라 설명을 위한 가정이다.
사용·공개 범위
공개 제품 출시가 아니라 레딧에 공유된 자체 운영 환경의 성능 측정이다. 공개 API나 업체가 운영하는 접속 주소는 제시되지 않았으며, 사용 가능 지역·가격·전체 설치 절차도 확인되지 않았다.
확인할 점
한 명의 게시자가 한정된 구성에서 작성한 표이며 표준화된 교차 장비 비교가 아니다. 수치는 입력 길이와 작업 유형에 따라 달라졌고, RDNA용 vLLM 수정 사항과 특정 AutoRound 양자화 설정에 의존한다. 모델 품질 손실에 관한 평가는 게시자의 추정이며 공식 보정 결과가 아니다. 원문 자동 수집도 제한돼 있어 독립적인 재현과 추가 검증이 필요하다.
용어 풀이
토큰: AI가 문장과 코드를 읽고 생성할 때 사용하는 작은 글 단위다. 단어 하나가 여러 토큰으로 나뉠 수도 있다. 양자화: 모델의 수치를 더 적은 정보량으로 표현해 메모리와 계산 부담을 줄이는 기법이다. 설정에 따라 정확도가 달라질 수 있다. vLLM: 그래픽카드에서 AI 모델의 답변 생성을 효율적으로 실행하도록 돕는 소프트웨어다.