AI가 며칠 전에 나눈 얘기까지 기억한다면, 긴 작업을 맡기기가 한결 편해지겠죠. Meta는 새 모델 Muse Wonder와 Muse Wonder Full에 대화 사이의 정보를 기억하고 엮는 Active Memory를 강조했어요. 회사 자체 시험에서는 Wonder가 기억·지속 학습 능력을 평가하는 MemoryBench에서 일부 경쟁 모델보다 높은 점수를 냈대요.
두 모델은 복잡한 코딩 작업도 겨냥했어요. 다만 개발자가 붙이는 방법은 달라요. Wonder는 Meta Model API와 Muse Code에서 쓸 수 있고, Wonder Full은 Muse Code 구독자용이라 API로 제공되지 않아요. 모델을 고를 때 코딩 성능뿐 아니라 이전 대화의 맥락이 필요한 작업인지, API 연결이 필요한지도 함께 살펴보면 좋겠어요.
※ Wonder API는 입력 100만 토큰당 4달러, 출력 100만 토큰당 20달러예요. 토큰은 AI가 글을 세는 단위이고, 기억 성능 수치는 Meta 자체 시험 결과예요.
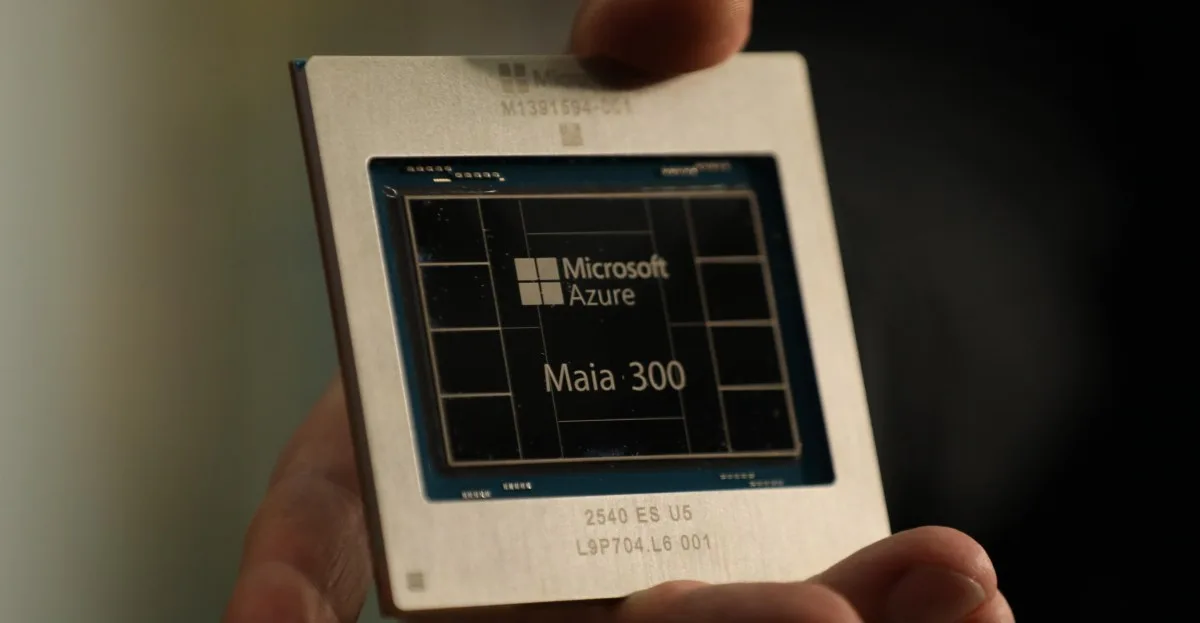
Microsoft가 자사 AI 서비스에 쓸 새 칩 Maia 300을 발표했고, 실제 운영에는 2027년부터 투입할 계획이에요.
AI가 질문에 답을 만들어 내는 과정을 추론이라고 해요. Microsoft는 이 일을 맡을 자체 칩 Maia 300을 발표했어요. 긴 내용을 참고해 답하거나 여러 단계를 이어서 처리하는 AI 작업에 맞춰 설계했다고 해요. 지금 쓰는 서비스의 칩이 곧바로 바뀐다는 뜻은 아니에요.
회사 말로는 Maia 300이 주요 GPU 기반 시스템보다 같은 전력당 토큰 처리량이 40% 높을 것으로 예상된대요. 또 가속기 96개를 묶은 구성에서는 이전 칩 Maia 200보다 랙 단위 토큰 처리량이 최대 7배라고 해요. 여기서 토큰은 AI가 글을 세는 단위예요. 클라우드에서 AI를 운영하는 개발자라면 실제 투입 뒤 비용과 응답 성능이 어떻게 달라지는지 확인할 만해요.
※ 생산용 AI 작업에는 2027년부터 투입할 계획이에요. 성능 수치는 Microsoft가 제시한 비교치예요.
Hacker News · arstechnica.com · 10월 10일 04:43 · 최근 주요 소식 보충
출처 이미지 · Hacker News · arstechnica.com
기업 개발 데이터를 분석한 연구에서 AI 코딩 에이전트 도입 뒤 코드는 늘었지만 완료된 작업은 뚜렷하게 늘지 않았어요.
AI가 코드를 빨리 써도, 사람이 검토할 시간이 그대로라면 작업 전체가 빨라지기는 어렵겠죠. 하버드대 연구진이 700곳 넘는 소프트웨어 기업의 개발 활동을 분석했어요. AI 코딩 에이전트 도입 뒤 작성된 코드 줄 수는 평균 30% 증가했지만, 이슈나 큰 기능 단위의 작업 완료율에는 통계적으로 뚜렷한 변화가 없었대요.
병목은 코드 리뷰에서 보였어요. 코드 변경을 제출한 뒤 본 코드에 합쳐지기까지 걸리는 평균 리뷰 시간이 49% 증가했거든요. 변경 요청과 리뷰 댓글도 늘었어요. 팀에서 에이전트를 쓰고 있다면 생성한 코드 양만 세기보다, 리뷰에 걸리는 시간과 완료된 작업 수를 함께 기록해 보는 게 좋겠어요. 이 연구는 관찰된 기업 데이터를 분석한 결과라 모든 팀에서 같은 변화가 일어난다고 단정할 수는 없어요.
※ 연구는 2026년 3월까지의 데이터를 살폈어요. 이후 도구와 팀의 사용 방식 변화는 반영하지 못해요.
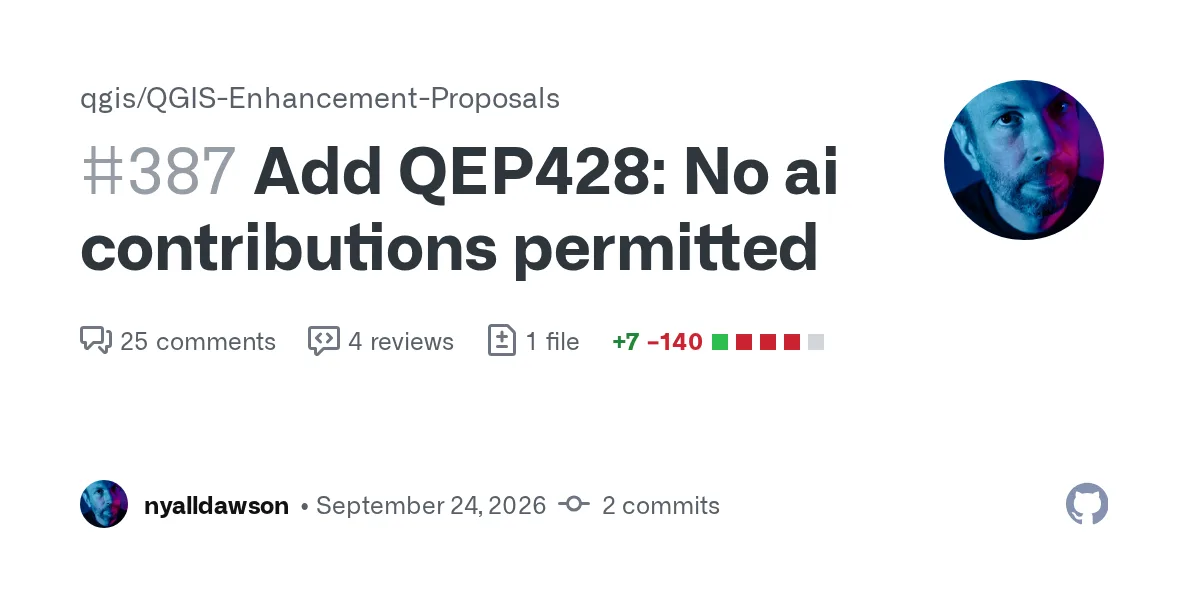
QGIS가 AI를 이용한 기여를 허용하지 않는 정책을 10월 7일 병합했어요. 지도 소프트웨어를 함께 만드는 개발자에게 적용되는 기여 기준이지, QGIS 사용자가 AI를 쓰지 못한다는 뜻은 아니에요. 프로젝트 구성원은 AI를 이용해 만든 제출물이 늘면서 검토 담당자의 부담이 감당하기 어려워졌다고 설명했어요.
이번 결정은 AI 활용 방법을 영구히 모두 금지하겠다는 선언보다는 우선 문을 닫는 조치에 가까워요. 제안자는 자동완성이나 번역처럼 허용할 만한 사례가 있다면 나중에 하나씩 논의할 수 있다고 했어요. 기여를 준비 중이라면 기존의 ‘사람이 검토하면 된다’는 기준을 그대로 적용하지 말고 새 정책을 먼저 확인하는 게 좋아요.
※ QGIS 기여자에게 해당해요. AI를 이용한 검토·보안 작업의 세부 범위는 별도 논의가 필요해 보여요.
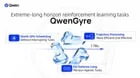
QwenGyre는 오래 실행되는 AI 에이전트를 학습할 때 GPU 대기와 중복 기록을 줄이려는 연구예요.
에이전트가 긴 작업을 수행하면 실행마다 끝나는 시간이 달라 GPU가 쉬기도 해요. 연구진이 제안한 QwenGyre는 작업 실행과 모델 학습 사이에서 GPU 배분을 바꾸되, 이미 진행 중인 실행은 끊지 않는 방식이에요. 재시도나 하위 에이전트 때문에 갈라진 작업 기록도 묶어 처리한다고 해요.
논문 저자들은 코드 저장소를 다루는 과제인 NL2RepoBench에서 학습 48단계 뒤 성적이 52.5%에서 58.5%로 올랐다고 보고했어요. 차이는 6%포인트예요. 긴 작업을 학습시키는 개발자라면 설계를 살펴볼 만하지만, 다른 환경에서도 같은 결과가 나는지는 확인되지 않았어요.
※ 현재 확인되는 건 연구 논문과 커뮤니티 소개예요. 공개 코드·라이선스·필요 장비는 확인되지 않았어요.
Decision 3.0은 긴 답변 대신 선택·예/아니오·점수로 결과를 돌려주는 공개 모델군이에요.
앱에서 필요한 게 설명문이 아니라 ‘어느 항목으로 보낼까?’ 같은 판단일 때가 있죠. 게시자에 따르면 vLLM Semantic Router 팀과 함께 공개한 Decision 3.0은 텍스트·이미지·비디오를 입력받아 선택지, 예/아니오, 점수 형태로 답해요. 모델 크기는 0.6B~27B로 소개됐어요.
예를 들면 들어온 내용을 어느 담당자에게 보낼지 정하는 라우팅 작업의 후보로 살펴볼 수 있어요. 게시자는 허깅페이스에 모델 가중치를 공개하고 Apache-2.0 라이선스를 적용했다고 밝혔어요. 도입 전에는 입력 형식과 실행 방법을 모델 카드에서 확인하고, 게시자의 성능 수치는 자체 평가 결과로 받아들이는 게 좋아요.
※ 공개 모델을 내려받아 검토할 수 있어요. 성능 수치는 독립적으로 검증된 결과가 아니에요.
코인베이스가 사기 탐지에 맞춰 학습한 소형 모델이 자체 평가에서 대형 모델보다 좋은 결과를 냈다고 밝혔어요.
코인베이스는 가중치가 공개된 Qwen3.5-9B를 자사 거래 위험 데이터로 추가 학습시켰어요. 결제 사기 위험을 분류하는 업무에 맞춘 거예요. 회사 말로는 내부 평가에서 Opus 4.5보다 정밀도가 7.5%포인트, 사기를 놓치지 않고 잡아낸 비율인 재현율은 12.0%포인트 높았대요.
속도는 별도로 측정했어요. 코인베이스가 밝힌 실제 서비스 요청의 응답 시간 중앙값은 0.683초로, Opus 4.5의 1.515초보다 짧았대요. 개발자라면 범용 모델을 바로 붙이기 전에 한 업무의 데이터와 평가 기준부터 모아볼 만해요. 다만 모두 자사 시스템에서 측정한 값이라 사기 수법이 바뀌면 다시 평가해야 해요.
※ 현재 코인베이스 내부 직원용 도구 얘기예요. 외부 제공은 확인되지 않았고 성능도 자체 평가 결과예요.
질문의 답 형식을 정해 주면 글을 생성하지 않고 선택이나 점수를 내는 소형 모델이 공개됐어요.
허깅페이스 기여자가 Typed Decision 모델을 공개했어요. 업무 상태와 질문의 답 형식을 적은 스키마를 주면 선택지, 점수, 예·아니요를 확률과 함께 돌려줘요. 문장을 만든 뒤 답만 추출할 필요가 없어, 예를 들면 고객 문의를 어느 팀에 보낼지 분류할 때 써볼 수 있어요.
typed-decisions 테스트의 2,000개 판단에서 개발자가 보고한 정답 일치율은 76.4%예요. 270억 매개변수 언어 모델보다 약 6%포인트 낮고, 매개변수는 약 100분의 1이라고 소개했어요. 테스트 데이터를 보며 설정을 골랐고 학습에 쓰인 질문 형식은 영어라, 실제 업무나 한국어에서도 같은 결과가 나온다고 보면 안 돼요.
※ 모델 파일은 허깅페이스에서 받을 수 있어요. 호스팅 실행 서비스는 아직 없고, 직접 실행할 때는 외부 코드 신뢰 설정이 필요해요.